Table of Contents
序章
自从开源模型以及agent的浪潮席卷世界后,私有化部署模型一直是个很热门的话题,主要原因在于可以满足用户对保护隐私数据、无token限制、本地模型微调等诉求。Alibaba Qwen系列的每次发布都会带上专门为本地化部署设计的小模型例如qwen-3.5 4B。而minimax最近发布的通用全模态生成模型minimax h3更是凭借着出色的设计类视频生成能力以及低成本的部署条件,又掀起了一波模型自部署的浪潮。
本人在业余时间也做过一些模型自部署的尝试,并且深入学习了很多AI infra的知识,因此从之前的笔记里整理了一些很有趣且实用的知识作为分享,通过本次学习读者可以对大模型技术有更深入的了解。
推理引擎:把模型托管为服务
模型文件放到机器上以后,还得有人把它跑起来。推理引擎加载权重、执行前向计算,替请求保管 KV Cache,并安排哪些请求一起算。外面再接上 API 服务,Agent 就能发送消息、接收逐步生成的结果。你在调用端看到的等待,往往就发生在这些计算和调度过程中。
自己在电脑上试模型,通常先接触 Ollama 或 LM Studio;要让一组 GPU 同时服务许多请求,vLLM 和 SGLang 会更常出现在企业级部署方案里:
- Ollama:侧重本地模型的管理与运行,提供命令行和 API,方便把模型接入个人应用或 Agent。
- LM Studio:提供图形界面,便于搜索、下载模型和直接聊天,也能开启本地 API 服务。
- vLLM:面向多请求的模型服务,通过连续批处理、分页 KV 管理等机制,提高吞吐量和显存利用率。
- SGLang:同样面向高性能模型服务,通过 RadixAttention 复用共享前缀的 KV,减少重复输入计算,并支持多 GPU 并行。
下面沿着一次 Qwen3-8B 调用往里看。输入已经发过去了,模型要先处理整段输入,才开始接着往下生成。
2.1 Prefill:输入并行计算
发给模型的消息会被切成 token。到这一步,输入里的每个 token 都已经确定,模型可以把它们一起送进网络,这个阶段叫 Prefill。图里把 4 个输入位置堆成矩阵 X,每一行是一条 token 向量;颜色标记这条向量属于哪个位置。走完 Qwen3-8B 的 36 层后,用最后一个输入位置的输出预测第一个新 token。
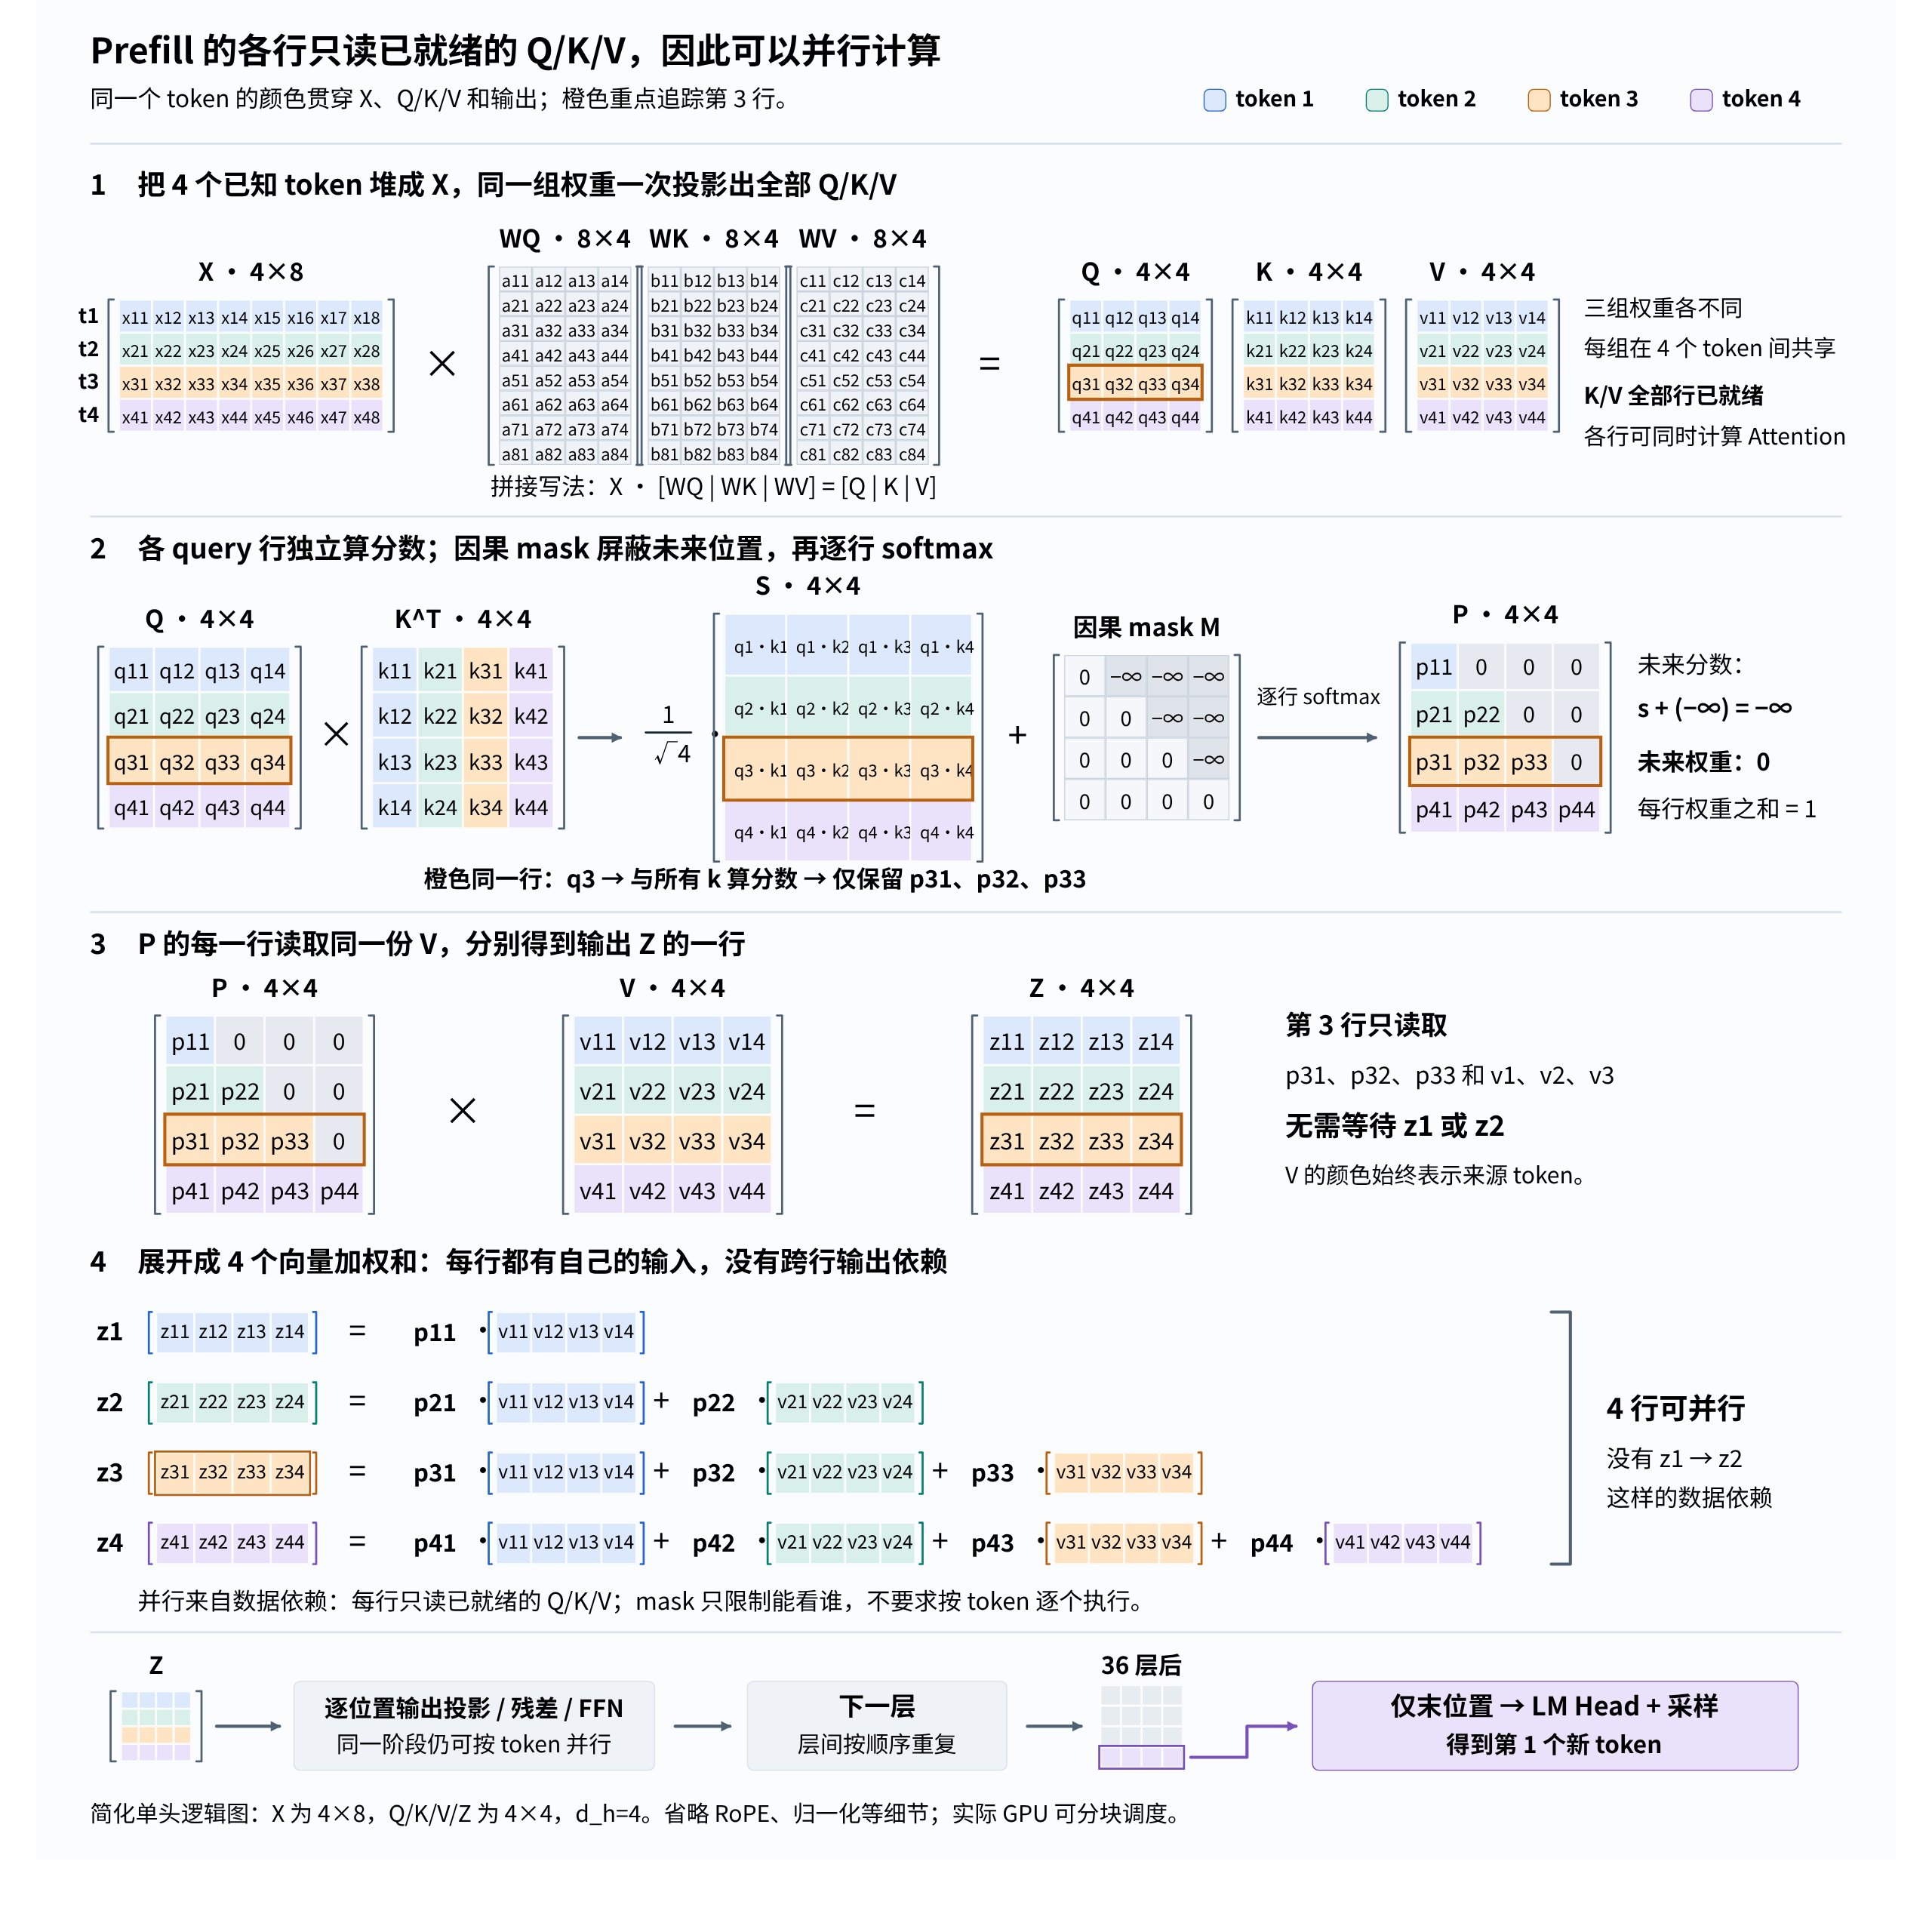
沿橙色的第 3 行看: 与 K 的各行求点积,第 4 个位置被因果掩码屏蔽。softmax 得到三个可见位置的权重,再对 加权汇总为 。下面展开的四行加权和,都只读取本层已就绪的 Q/K/V。各输出行之间没有先后依赖,因此可以同时计算。
这些 Q/K/V 来自上一层已经算好的输出,首层则来自 Embedding;投影和后续逐位置 FFN 也能按行批量执行。层与层之间仍要按顺序往下走,下一层要使用这一层的计算结果。
因果掩码把未来位置的分数设为 −∞,经过 softmax 后权重变成 0。图画的是计算依赖,实际 GPU 会按硬件资源分块调度;可以并行,不代表所有位置都在同一时刻执行完毕。
图里的 Q、K、V 来自三次投影:。接下来让 Q 与 K 算分数,屏蔽未来位置,再对 V 加权:
softmax 沿每一行计算;是单头维度。下面把维度缩小为输入 8 维、单头 4 维,使用随机权重,只演示一层单头 Attention,省略位置编码、归一化和 FFN。2.1、2.2 的代码按顺序运行,仅需 PyTorch,CPU 即可。
import torchtorch.manual_seed(7)T, d, dh = 4, 8, 4  # 4 个位置;输入 8 维;单头 4 维X = torch.randn(T, d)Wq, Wk, Wv = [torch.randn(d, dh) for _ in range(3)]
def prefill(x):    q, k, v = x @ Wq, x @ Wk, x @ Wv    scores = q @ k.T / dh**0.5    allowed = torch.ones(len(x), len(x), dtype=torch.bool).tril()    p = scores.masked_fill(~allowed, float("-inf")).softmax(-1)    return p @ v, k, v, p
z, K_cache, V_cache, p = prefill(X)print(p.triu(1).abs().max().item())  # 0.0:未来位置的权重全为零
2.2 Decode 与 KV Cache:逐步生成与历史复用
生成时就没这么方便了。Prefill 选出 token A 后,模型得把 A 送回去,才能预测 B;B 选定后,才能继续预测 C。后面的输入还没确定,只能一轮接一轮地生成。这是普通自回归 Decode 的串行依赖,每轮内部的计算仍可并行,多条请求也能一起算。
如果每轮都把整段历史重算一遍,对话越长,重复的工作就越多。好在因果 Attention 的历史位置看不到新追加的内容:模型、位置编码等条件相同时,末尾加了一个 token,前面各层已经算好的 K/V 不会变。把它们存下来,下轮直接读,就有了 KV Cache。
图中只画一轮 Decode:输入已确定的 A,读写各层 KV,经过全部层后选出 B,再把 B 送回输入端。Attention 使用与 2.1 代码相同的教学维度。
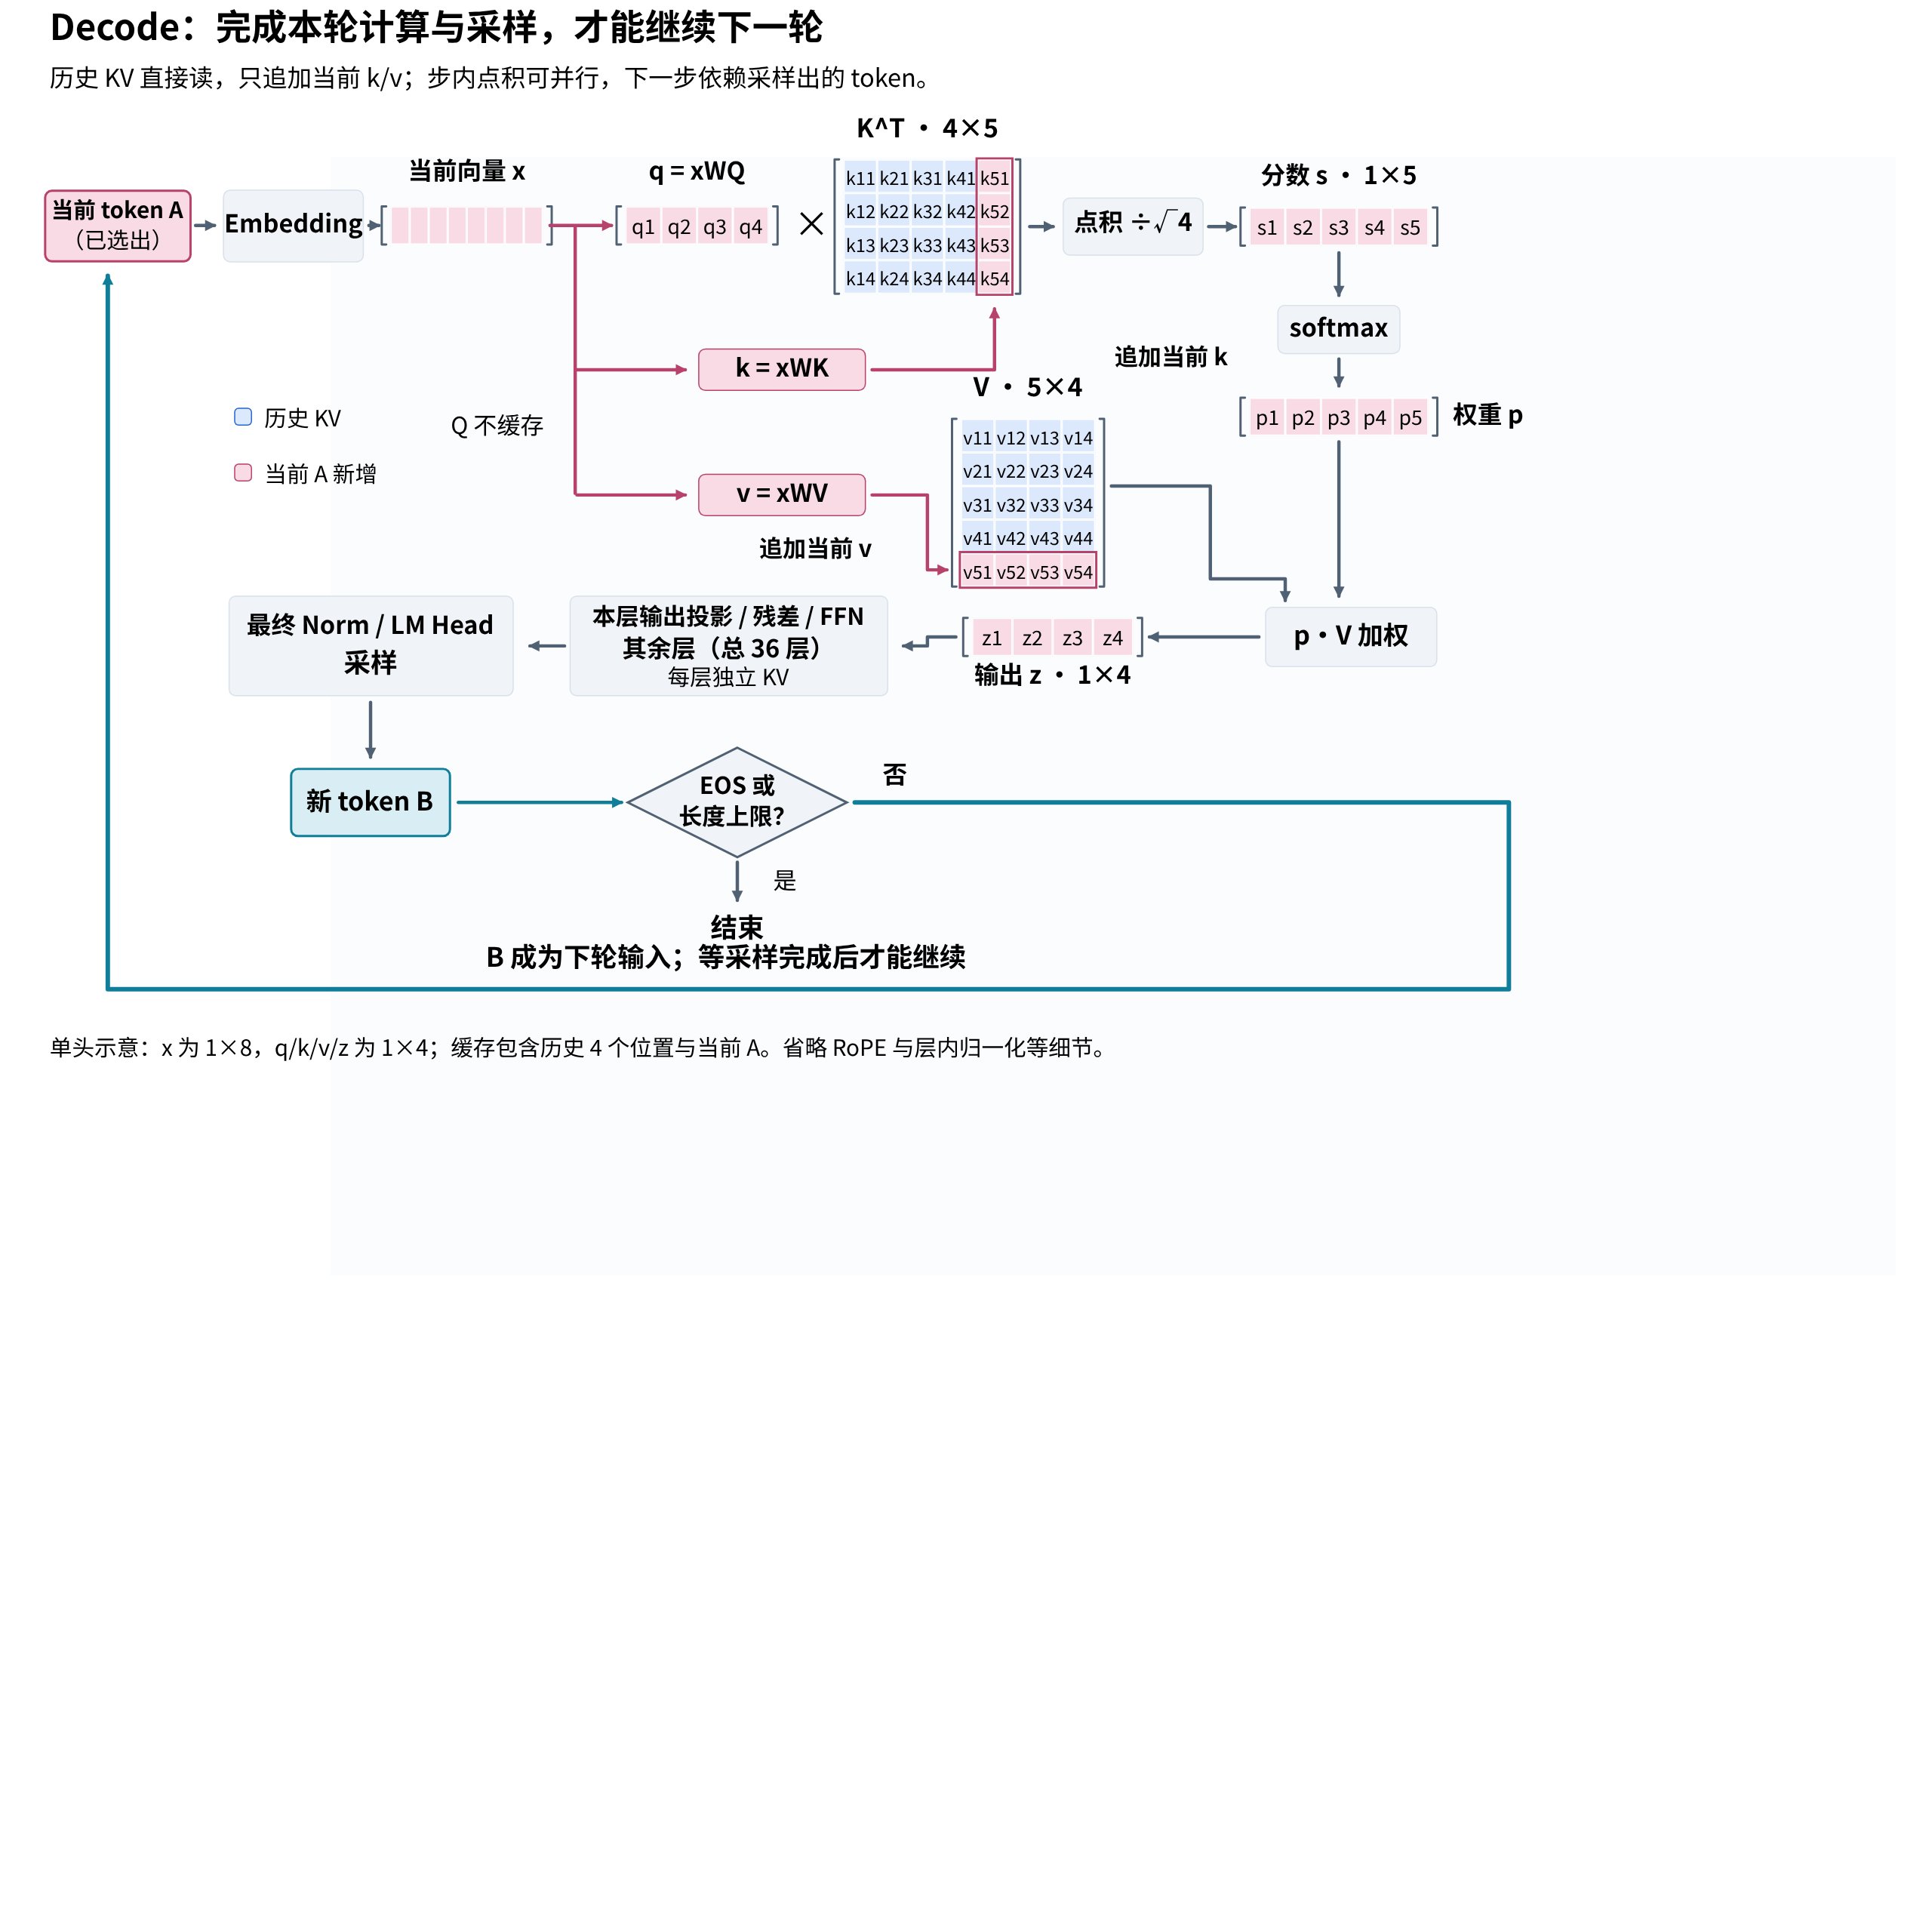
沿回箭头看,B 选定后,下一轮才能开始。本轮缓存只新增 A 的 K/V;B 的 K/V 要到下一轮处理 B 时才产生。
历史 Q 已经完成各自的查询,后续步骤不再使用,所以只缓存 K/V。 缓存省掉了历史位置的重复计算;当前新位置的投影、FFN,以及新 Q 对历史 K/V 的 Attention 仍要执行。KV Cache 计算过程里可以对照每一步。
代码演示可以参考如下demo:
x_new = torch.randn(1, d)  # 已确定的新位置在这一层的输入q = x_new @ Wqk_new, v_new = x_new @ Wk, x_new @ WvK_next = torch.cat([K_cache, k_new], dim=0)V_next = torch.cat([V_cache, v_new], dim=0)p_new = (q @ K_next.T / dh**0.5).softmax(-1)z_cached = p_new @ V_next
# 对照:将全部历史和新位置拼起来,从头计算z_full, *_ = prefill(torch.cat([X, x_new], dim=0))torch.testing.assert_close(z_cached, z_full[-1:])print(tuple(K_next.shape), tuple(z_cached.shape)) # (5, 4) (1, 4)demo的演示只算新位置,结果与整段重算的最后一行一致。打印的 (5, 4) (1, 4) 表示缓存现在有 5 个位置,本轮只得到 1 行输出。新 Q 已经在序列末尾,缓存里的位置都能看见,因而不需要再加方阵三角掩码。
这里用 torch.cat 把新 K/V 接在末尾,便于看清数据怎么变。真实引擎通常提前分配空间或使用分页缓存,直接写入新位置,免得每轮都复制全部历史。2.5 再看分页时的地址是怎么算出来的。
2.3 算力与带宽:Prefill 和 Decode 的性能瓶颈
同样跑一遍模型,Prefill 和 Decode 对硬件的需求却不一样。只拿 Q 投影来算:权重相同,精度都是 BF16,Prefill 一次处理 1024 个位置,单请求 Decode 只处理 1 个。差别就在同一份权重被用了多少次。
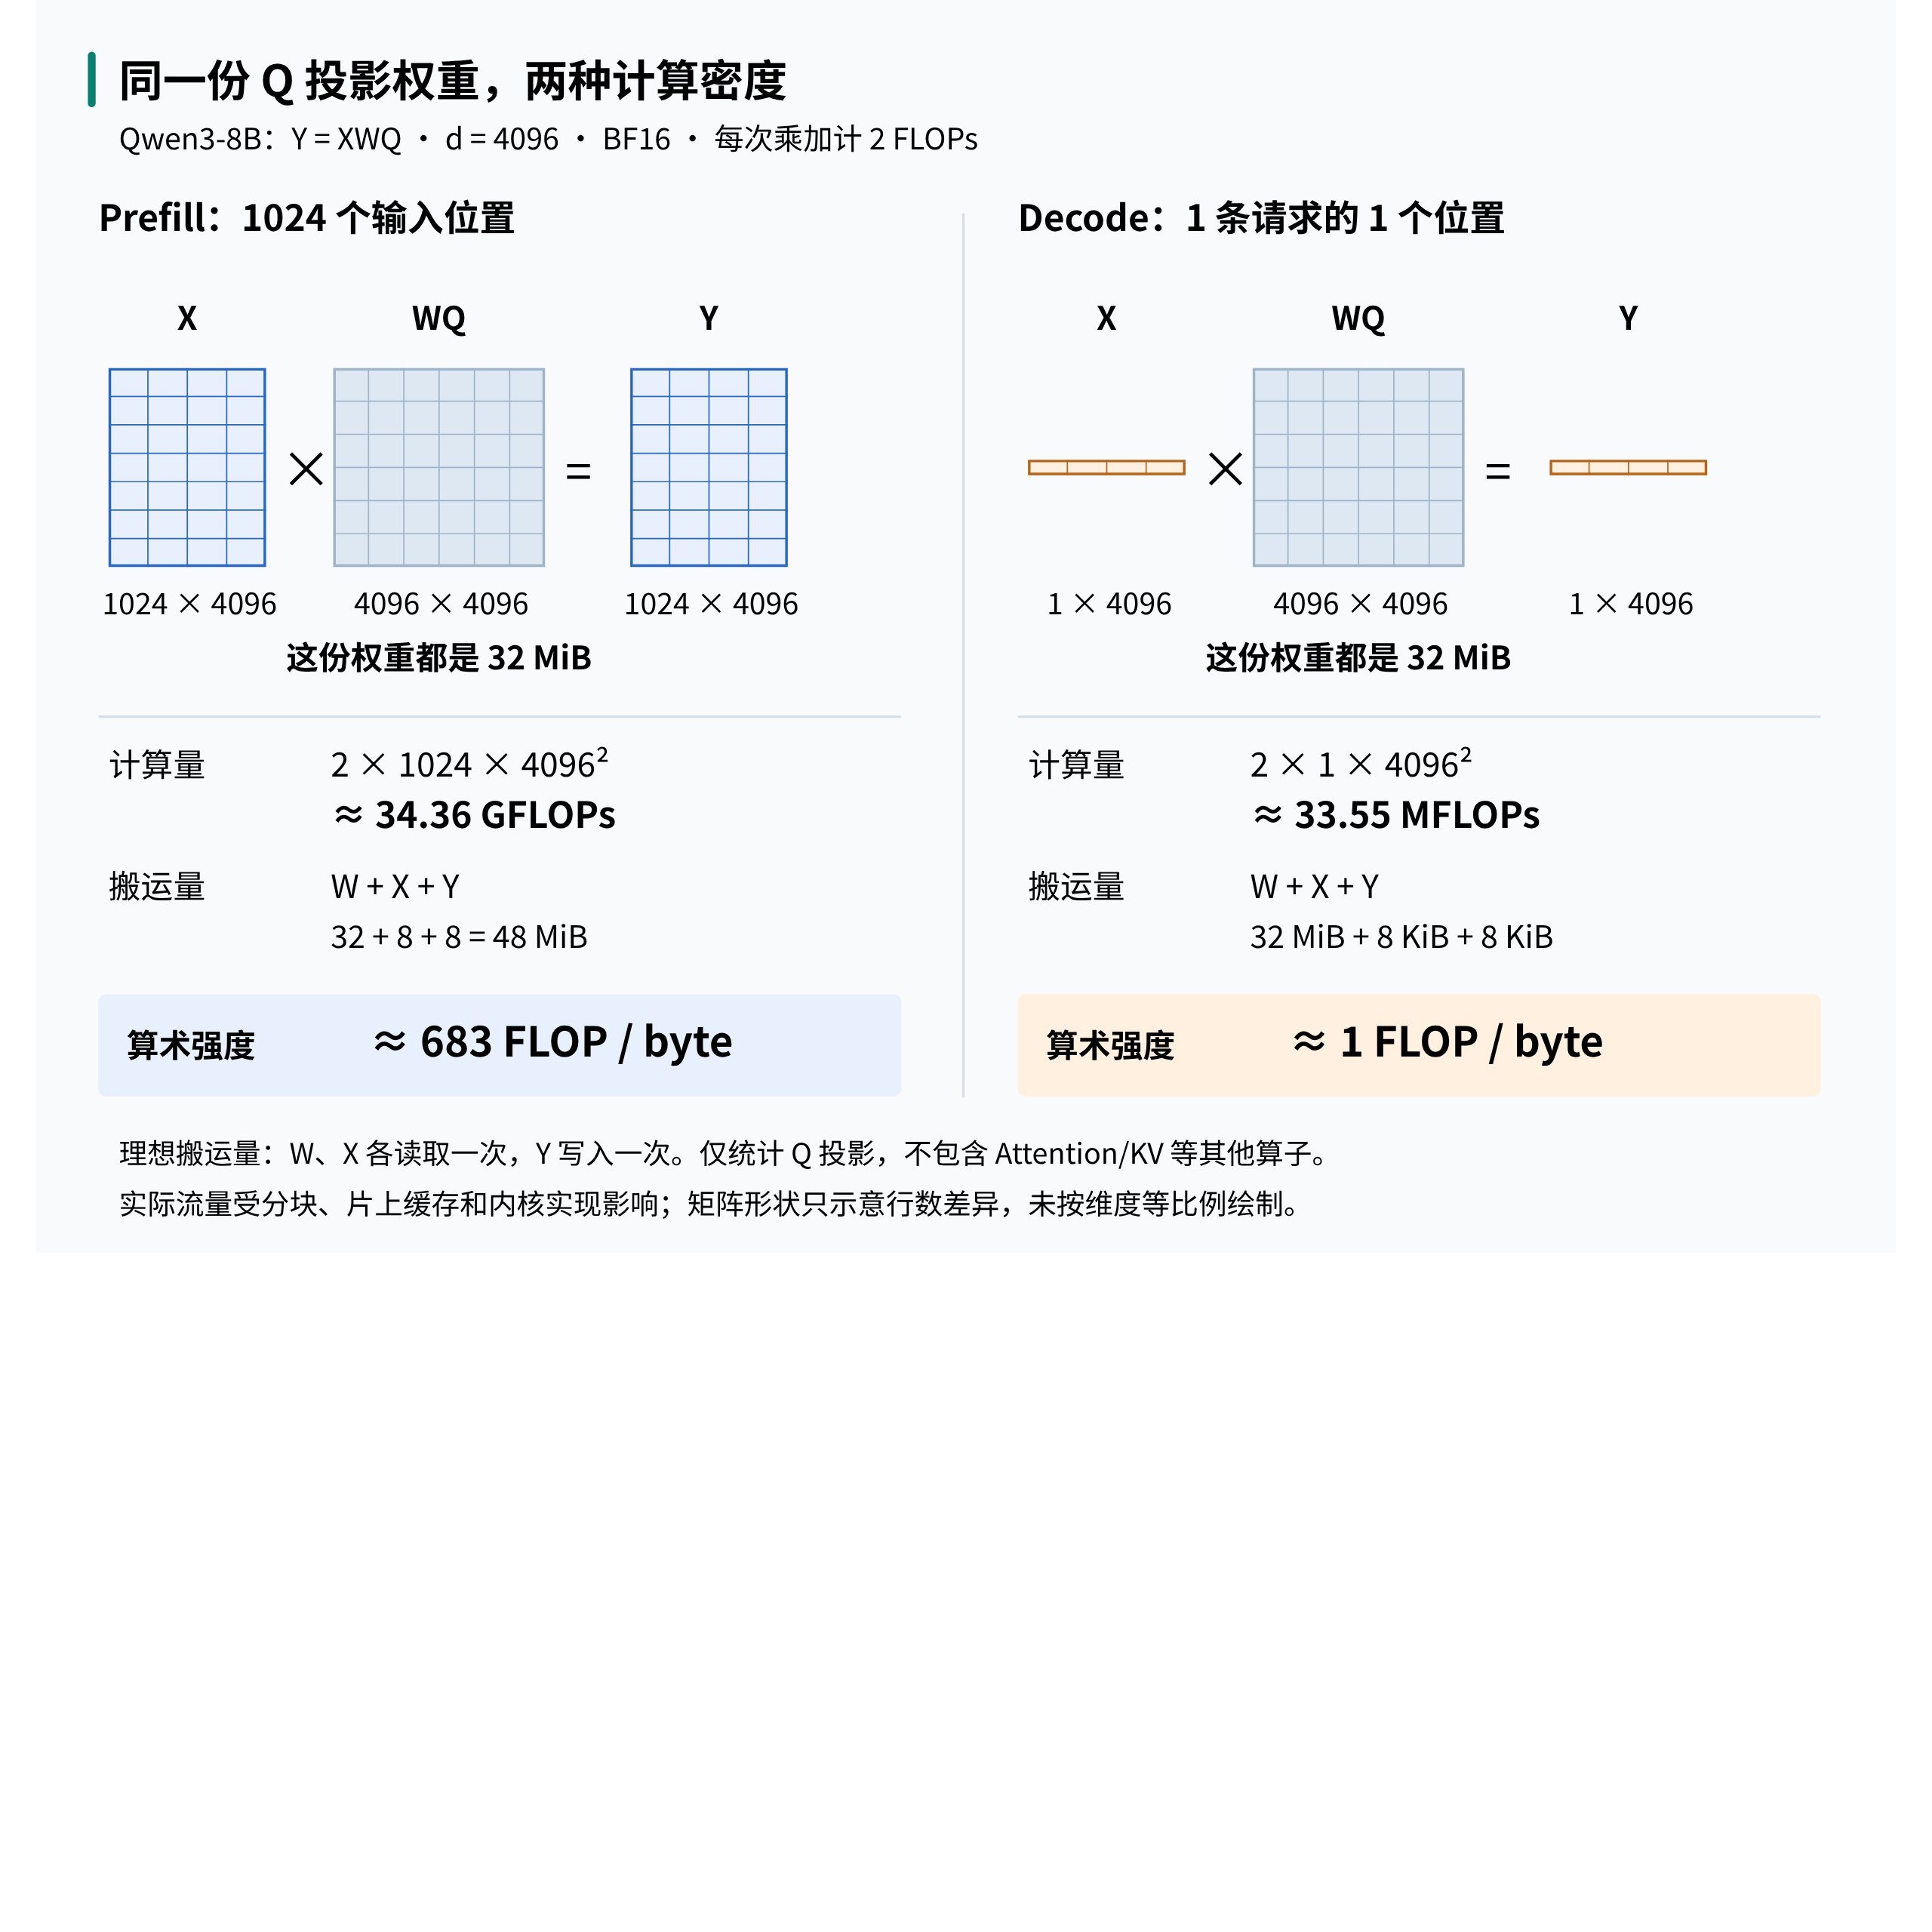
输入足够长时,读出一份权重后要做大量乘加,Prefill 往往更容易受算力限制,叫 compute-bound。小批量 Decode 每轮只算少数几个新位置,却还得读大量权重和历史 KV,往往更容易受显存带宽限制,叫 memory-bound。这里卡住的是数据搬运速度,显存容量充足也会遇到。
把两笔时间分别算出来:F 次运算,除以峰值算力 P;D 字节数据,除以峰值显存带宽 β。P 取当前计算精度对应的数值。先忽略启动和调度开销,假设计算与搬运能充分重叠,理想耗时就取两者中较大的一个:
I 是算术强度,也就是每搬 1 字节能做多少次运算。当 时,上面的估算会卡在搬数据这一步,反过来则卡在计算。用几行代码算算图里的差距,W 和 X 各读一次,Y 写一次:
d, bytes_per_value = 4096, 2for n in (1, 1024): flops = 2 * n * d * d moved = (d * d + 2 * n * d) * bytes_per_value print(n, round(flops / moved, 2))# 输出:1 1.0;1024 682.67(FLOP/byte)同一块 GPU 上,输入很短时,Prefill 也可能来不及发挥算力,受启动开销或带宽限制;把许多 Decode 请求合成一批,权重又能被多次复用;历史越长,读 KV 的开销也越大。所以图里的单个算子只能帮我们理解瓶颈,整模型速度还得结合负载看。推导可参考 NVIDIA 算术强度说明和 Transformer 推理性能分析。
输入与输出的价格差异
下面比较普通输入(未命中缓存)与输出的官方 API 单价,单位为美元 / 百万 token。价格核对于 2026 年 9 月 16 日;GPT-6 Astra 采用短上下文标准价,DeepSeek 采用高峰价。
| 模型 | 输入 token | 输出 token | 输出 / 输入 |
|---|---|---|---|
| Claude Sonnet 4.6 | $3 | $15 | 5 倍 |
| GPT-6 Astra | $10 | $50 | 5 倍 |
| DeepSeek-V4.1-Flash | $0.30 | $1.20 | 4 倍 |
这个差距可以接回前面的计算过程:Prefill 能同时处理多个输入 token,把读取权重的开销摊到多个位置;输出则要逐步 Decode。每个请求都要等上一个 token 生成,才能算下一个。小批量时,每轮仍需读取大量权重和历史 KV,每个输出 token 分摊的搬运开销更大。这有助于解释输出为何更贵,但具体价格倍数还取决于厂商的定价策略。
2.4 FlashAttention:分块计算与显存读写
回到 2.1 的 Attention。朴素实现先算出整张分数矩阵,写进显存;再读出来做 softmax,把结果写回;最后又读出来与 V 相乘。中间结果在显存里来回搬,也会耗时。Prefill 通常偏算力受限,说的是整体负载,其中的 softmax 等步骤仍可能受带宽限制。
FlashAttention 把 Q/K/V 分块搬进更快、容量更小的片上 SRAM,算完一块就更新输出。
输入有 N 个位置时,完整的 分数和权重矩阵不再写入显存 HBM。分块与融合的原理见 FlashAttention 论文。
Softmax 把一行分数转换成总和为 1 的概率。设 是第 i 个分数, 是它对应的概率,计算方法是取指数后除以整行的指数和:
右边是图中采用的稳定写法:减去同一个最大值 m 不改变结果,但能避免指数溢出。普通 Softmax 先求整行的最大值和指数和;Online Softmax 则逐块更新,下面对比两者的计算过程。
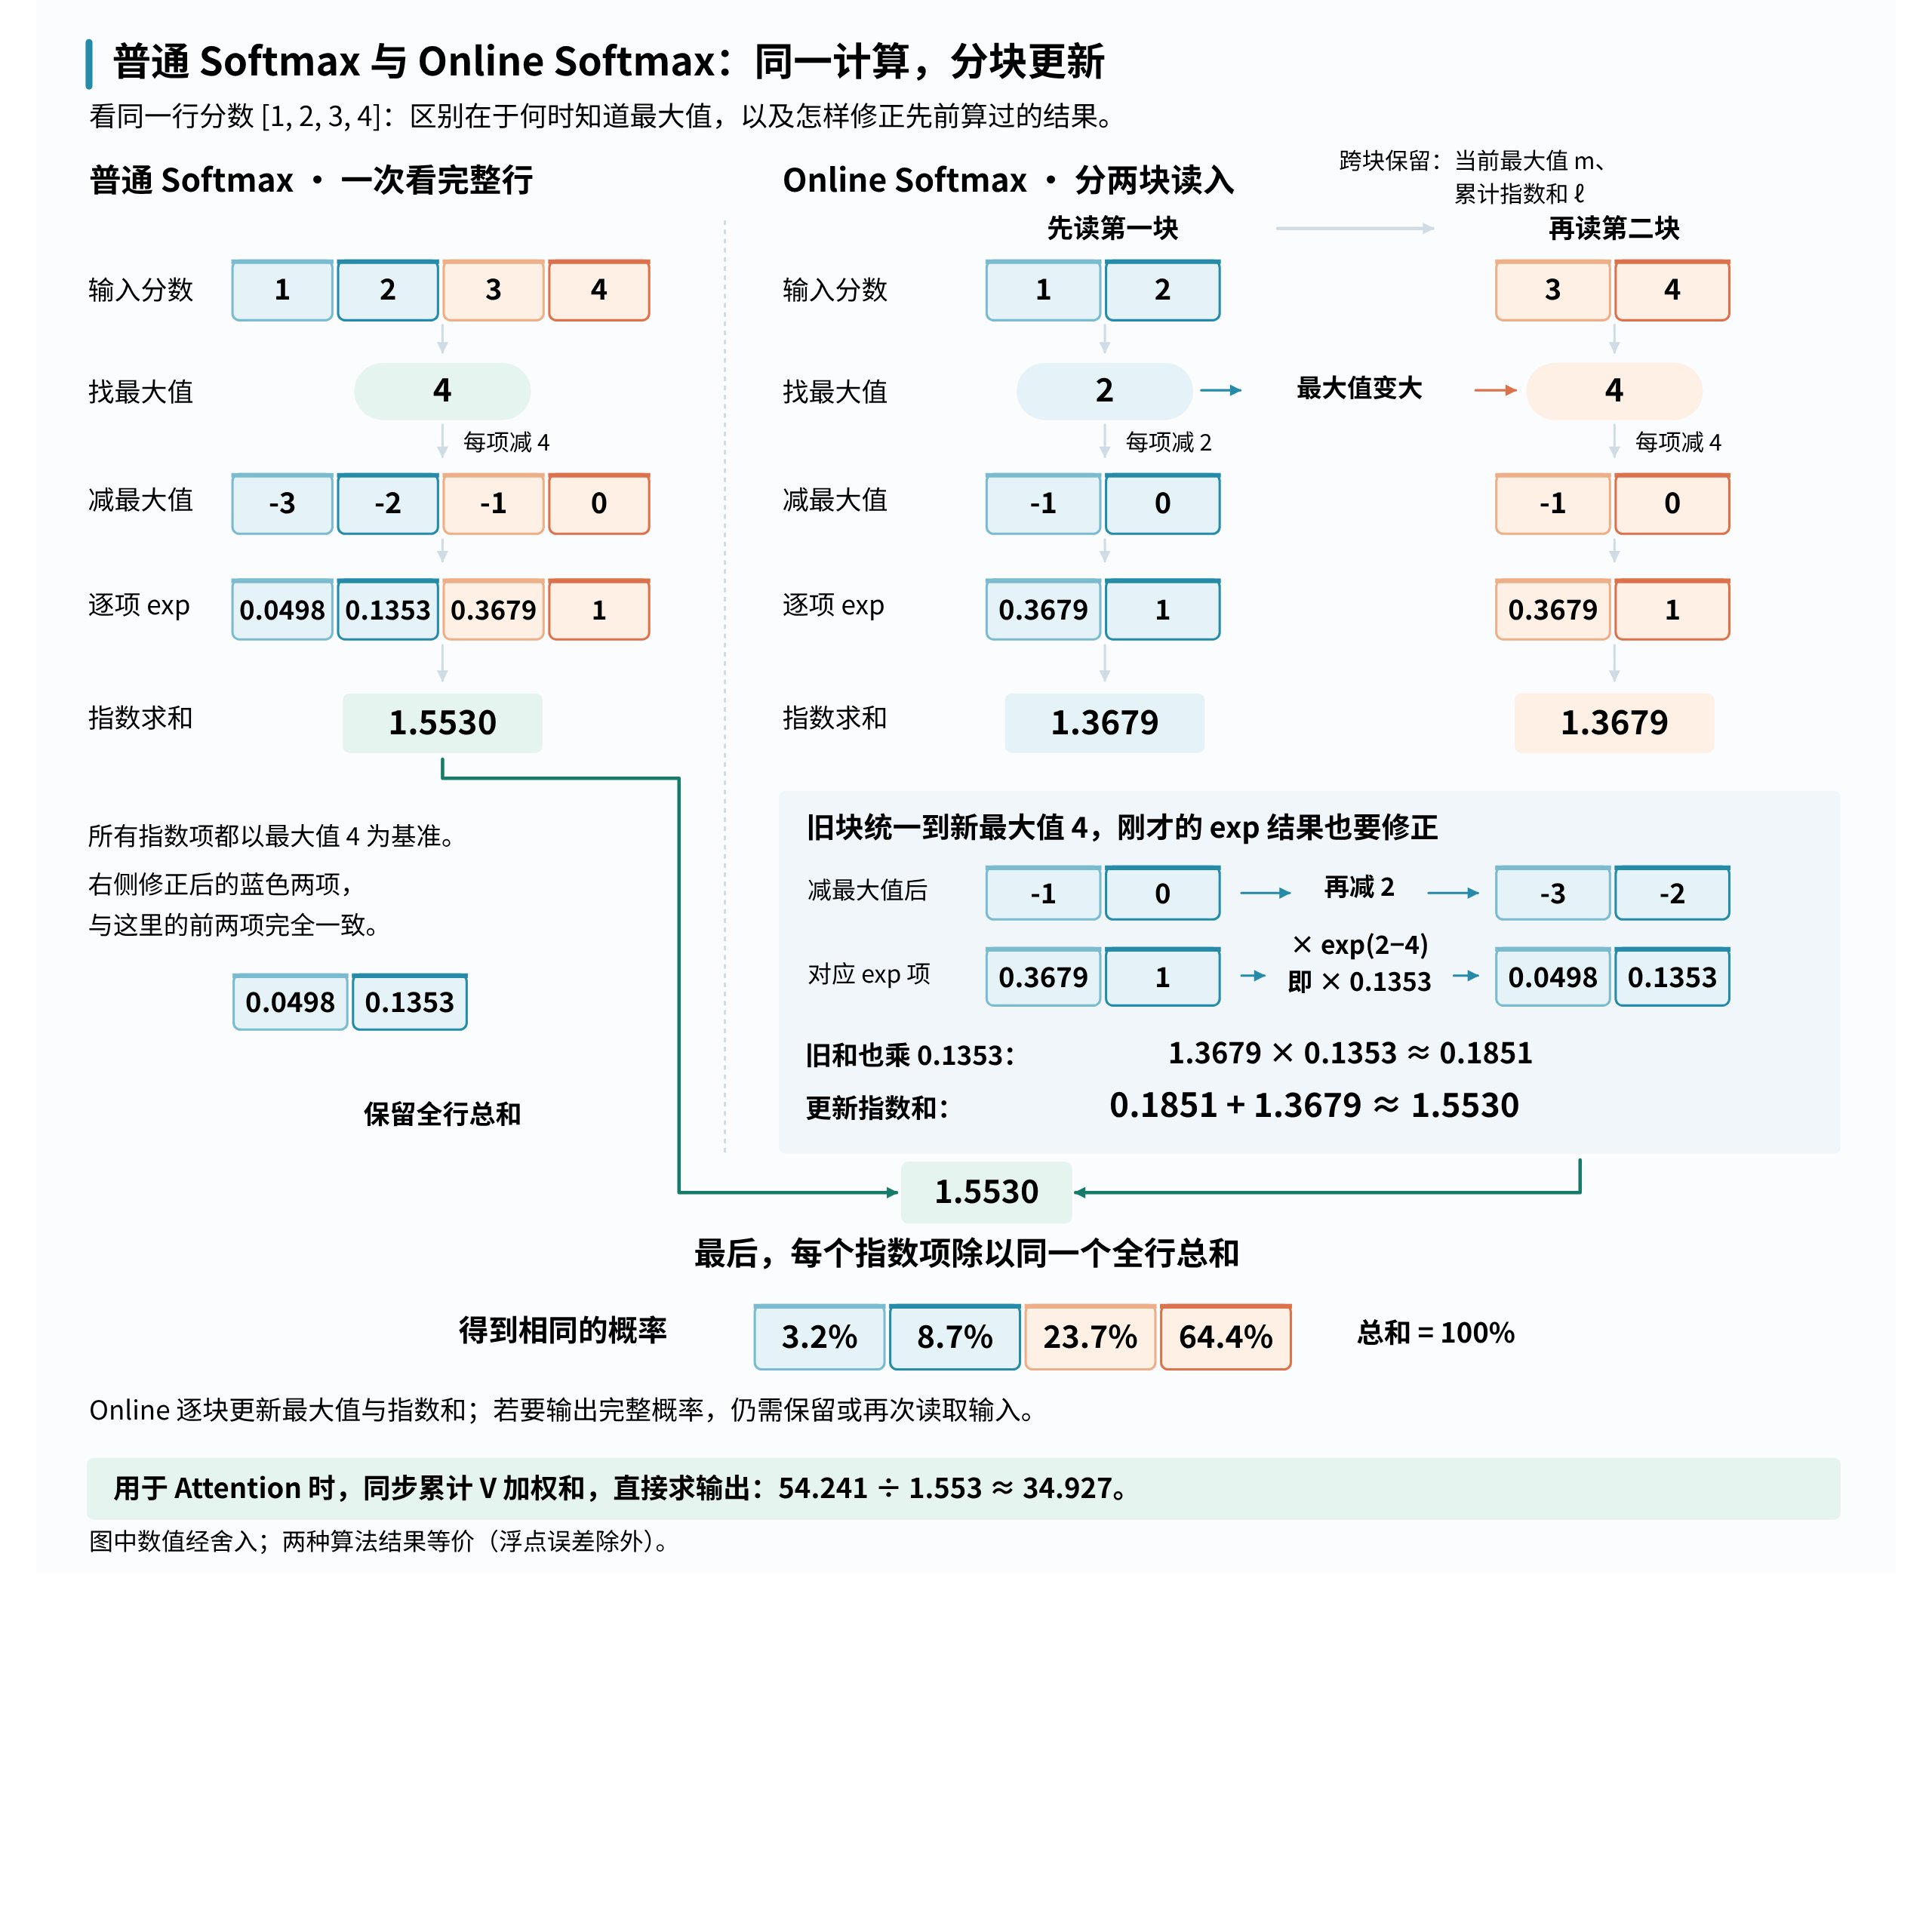
Attention 最终使用的是 V 的加权输出。Online Softmax 让分数块一算完,就能更新最大值、指数和与 V 的加权累计量;新块到来时,再统一修正旧结果。FlashAttention 于是能把“算分数 → softmax → 乘 V”在 SRAM 内按块接起来,省掉完整分数和概率矩阵在 HBM 中的存储和往返读写。
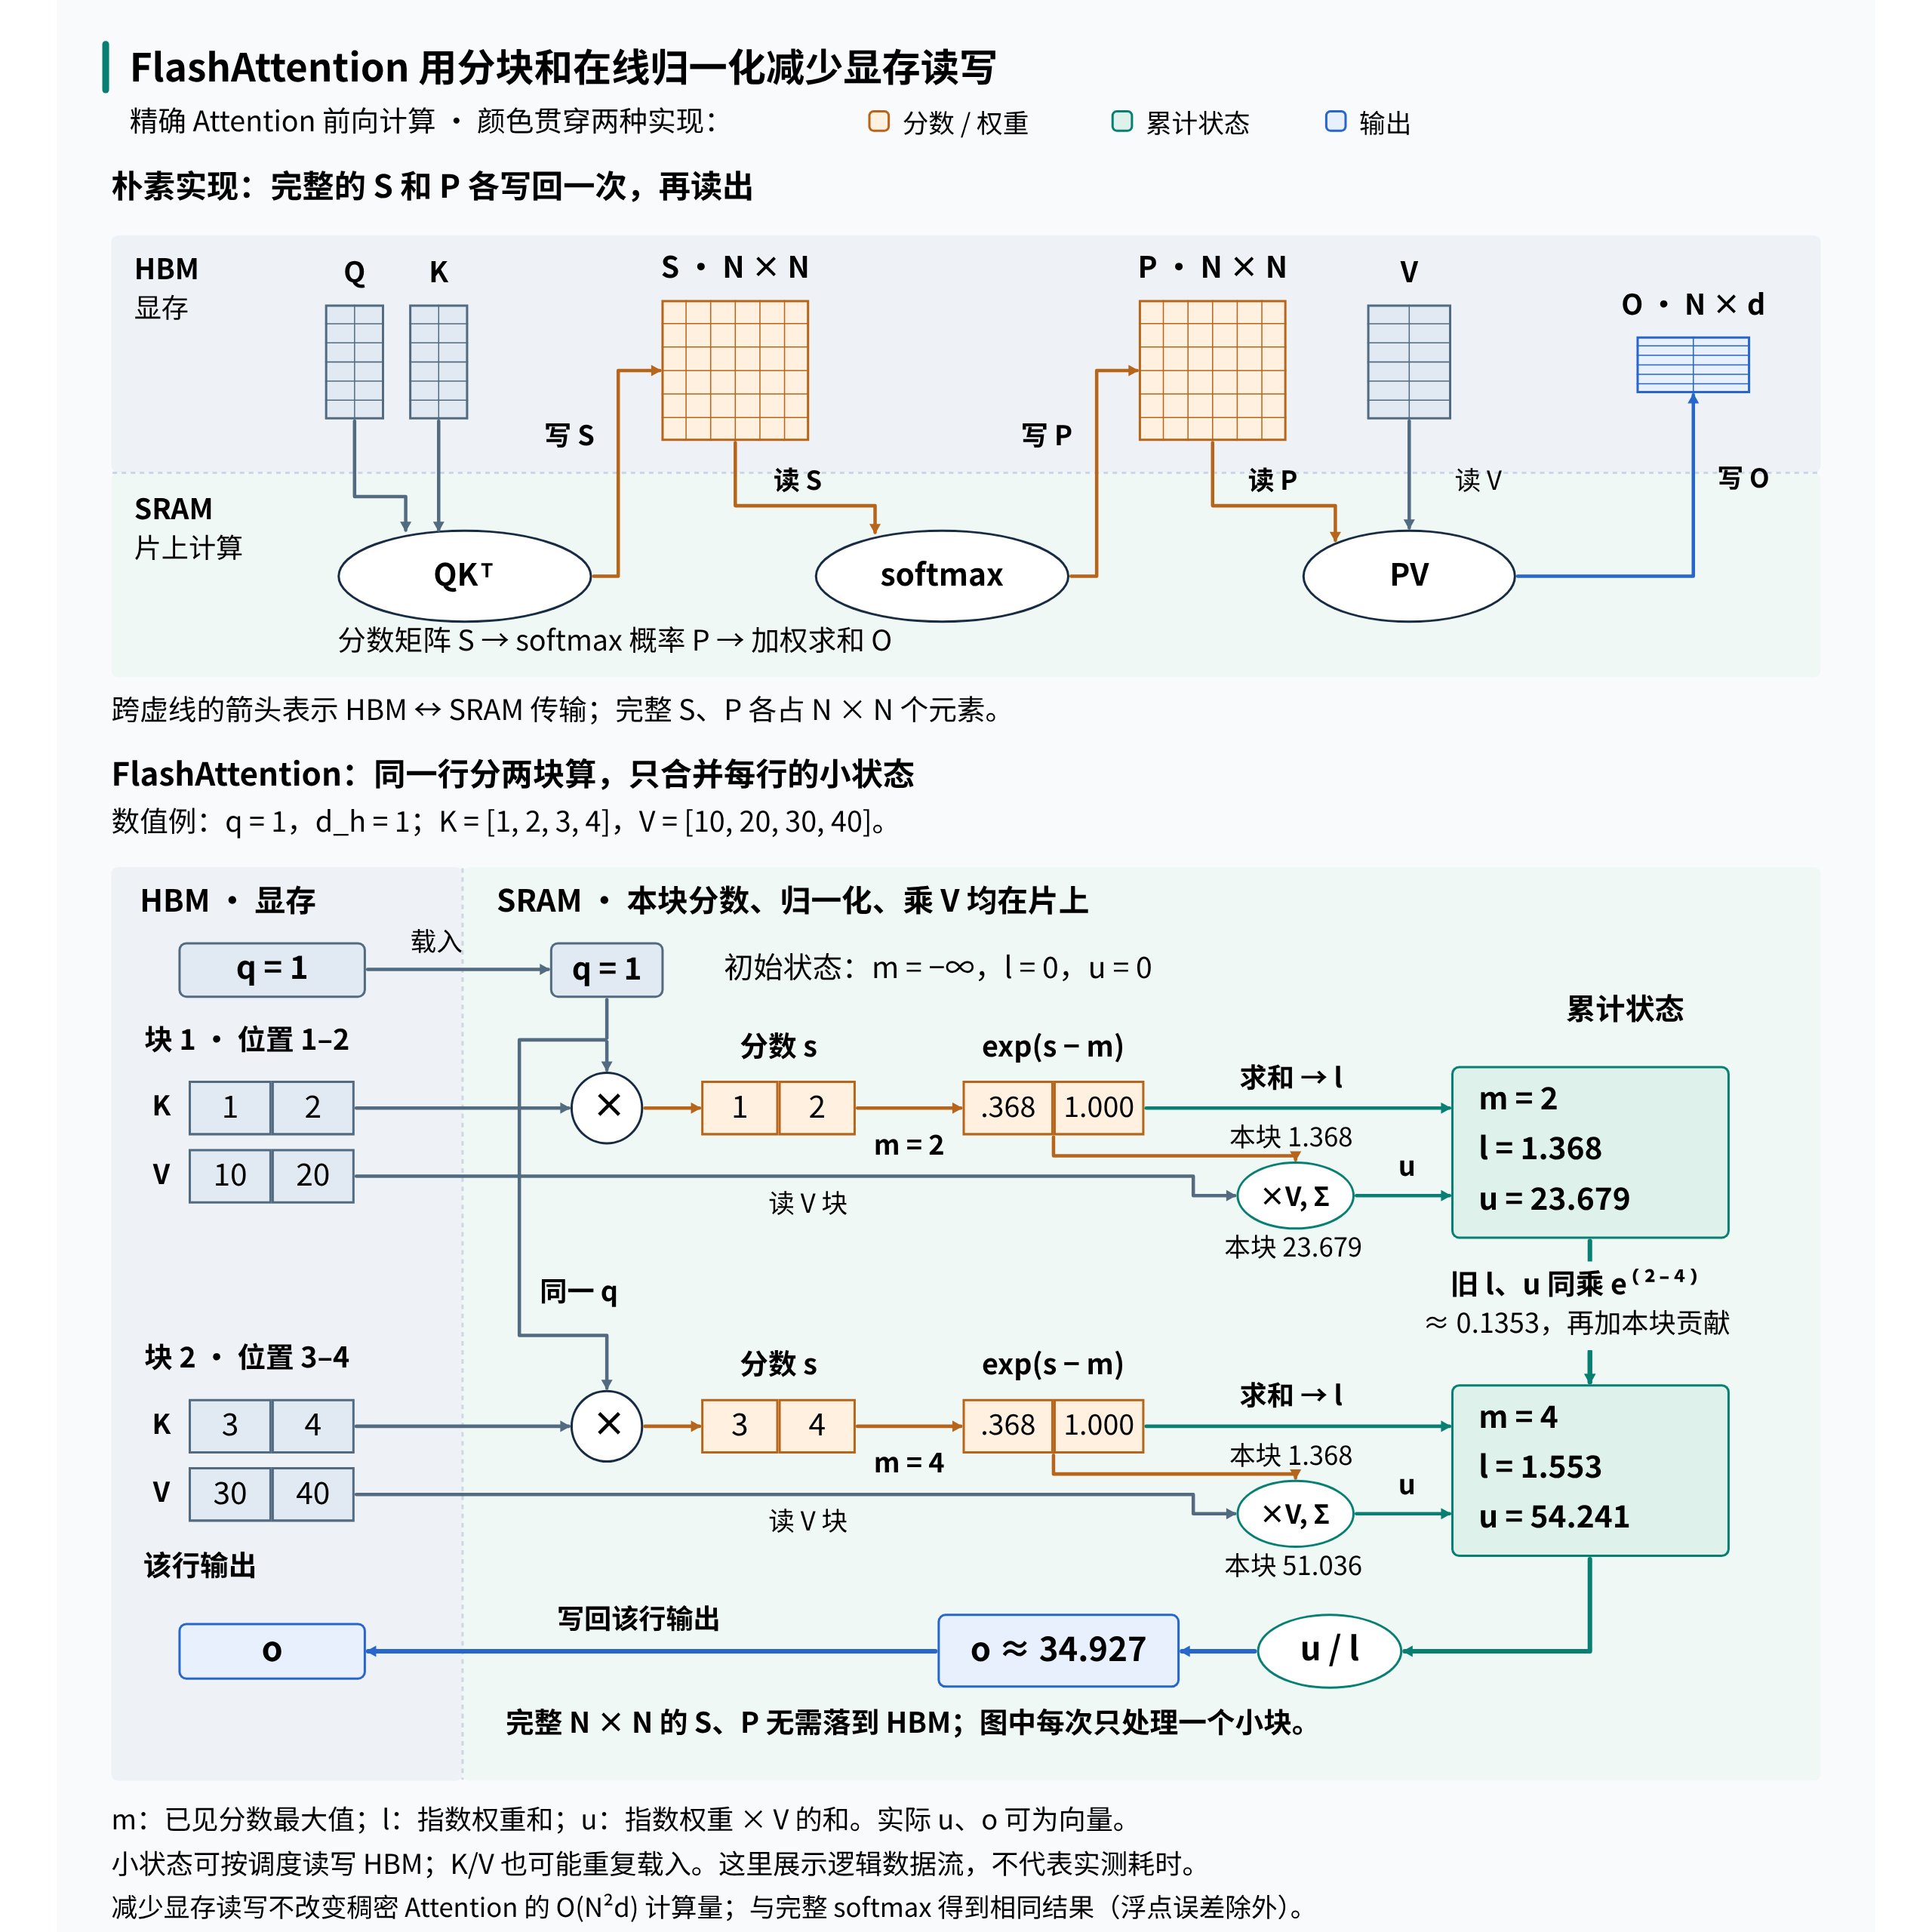
下面用代码对照图中的两块计算:把头维度缩成 1,取分数 [1, 2, 3, 4]、V 为 [10, 20, 30, 40],每块两个位置。
import torch
def online_attention(q, k, v, block_size=2):    # 只演示一个 Q 行;这些 K/V 都对它可见。    m, ell = q.new_tensor(float("-inf")), q.new_tensor(0.)    u = q.new_zeros(1, v.shape[-1])    for start in range(0, len(k), block_size):        kb, vb = k[start:start + block_size], v[start:start + block_size]        scores = q @ kb.T / q.shape[-1]**0.5        m_new = torch.maximum(m, scores.max())        alpha = torch.exp(m - m_new)  # 把旧状态换到新的最大值下        weights = torch.exp(scores - m_new)        ell = alpha * ell + weights.sum()        u = alpha * u + weights @ vb        m = m_new    return u / ell
q_f = torch.tensor([[1.]], dtype=torch.float64)k_f = torch.tensor([[1.], [2.], [3.], [4.]], dtype=torch.float64)v_f = torch.tensor([[10.], [20.], [30.], [40.]], dtype=torch.float64)o_block = online_attention(q_f, k_f, v_f)o_full = (q_f @ k_f.T / q_f.shape[-1]**0.5).softmax(-1) @ v_ftorch.testing.assert_close(o_block, o_full, rtol=1e-12, atol=1e-12)print(round(o_block.item(), 6), round(o_full.item(), 6))# 输出:34.926527 34.926527
两边都得到 34.926527。第二块把最大分数从 2 提高到 4,旧的权重总量和加权总量都缩到原来的约 13.5%,再加入新块。这种边读边更新的办法见 online softmax 论文。代码验证了数值结果;真实 GPU 内核还会把分块计算融合起来,减少中间结果的显存读写。
FlashAttention 保留精确 Attention 的计算,稠密 Attention 的算术量仍是平方级。
这里“精确”允许正常的浮点舍入差异。它减少了中间矩阵的存储和搬运,后续 Decode 所需的 KV Cache 仍要保留。
2.5 连续批处理与分页:请求调度和 KV 管理
前面看的是一次 Attention 计算如何加速。推理服务还要同时处理很多请求。假设 8 条请求都在用同一个 Qwen3-8B 生成回答:对话内容不同,用的却是同一套模型权重。
计算投影时,把每条请求当前这一步的向量排成一行,8 行一起乘同一个权重矩阵,GPU 就能并行计算这些行,输出仍然一行对应一条请求。权重可以共用,每条请求的 Attention 仍只读取自己的上下文。
效率提升来自权重的复用。逐条处理时,一块权重从 HBM 读进片上,只为一条请求计算;合成一批后,读进来的同一块权重可以用于 8 行输入,再换下一块。
一次搬运服务的请求多了,摊到每个输出 token 上的权重读取成本就降下来了。在权重搬运是主要瓶颈时,GPU 能少花些时间反复读权重,多做些计算,从而提高总吞吐。这也是 NVIDIA 文档中矩阵计算提高算术强度的原理。
各条请求仍要做计算、读写自己的 KV,8 条合批并不代表实测一定快 8 倍。
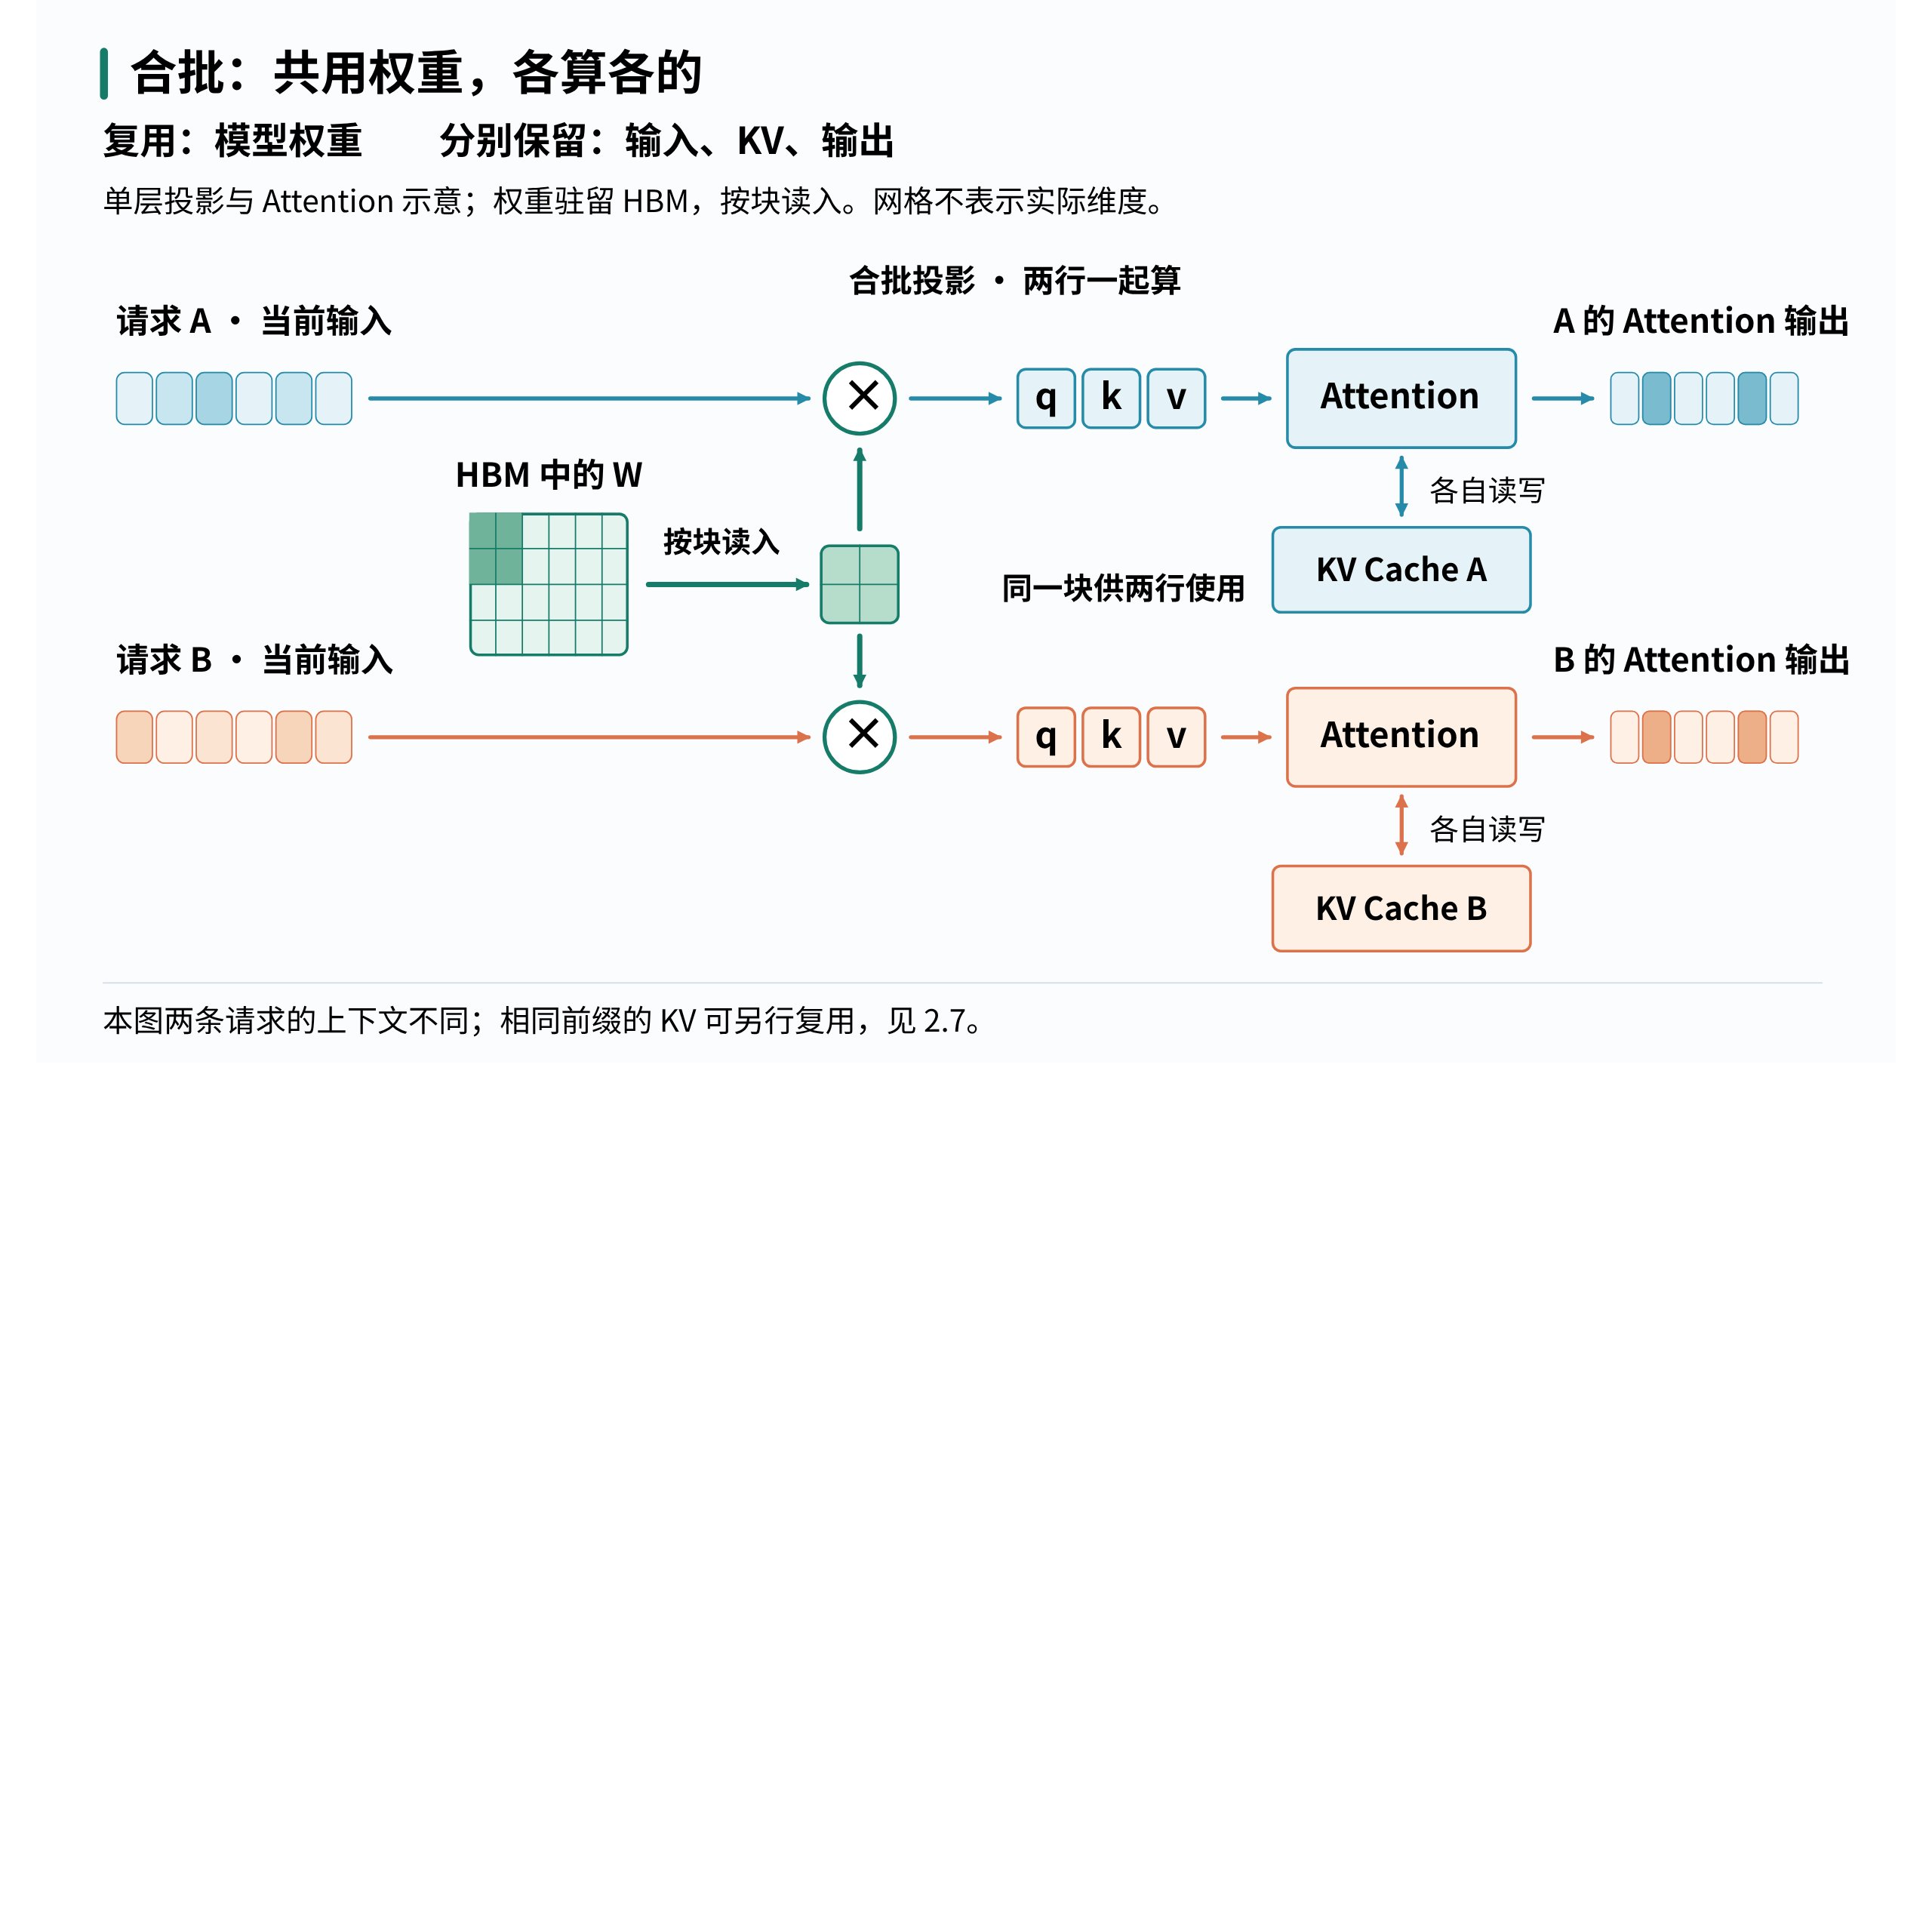
合批能复用权重。接下来还要解决两件事:谁一起算,以及各自的 KV 怎么存、怎么读。
连续批处理(Continuous Batching):每轮调整批次。- 完成的请求退出;新请求在资源允许时加入,不必等最慢的请求。
- 每轮一起处理的请求数,就是 batch size。
PagedAttention:按块存 KV,按块表读 KV。
- 按需分配:KV 分成固定大小的块,空间不够再申请,避免提前预留最大长度。
- 按表读取:块可以散放在显存里;块表记录位置,Attention 按表找到 K/V,无需先拼成连续空间。
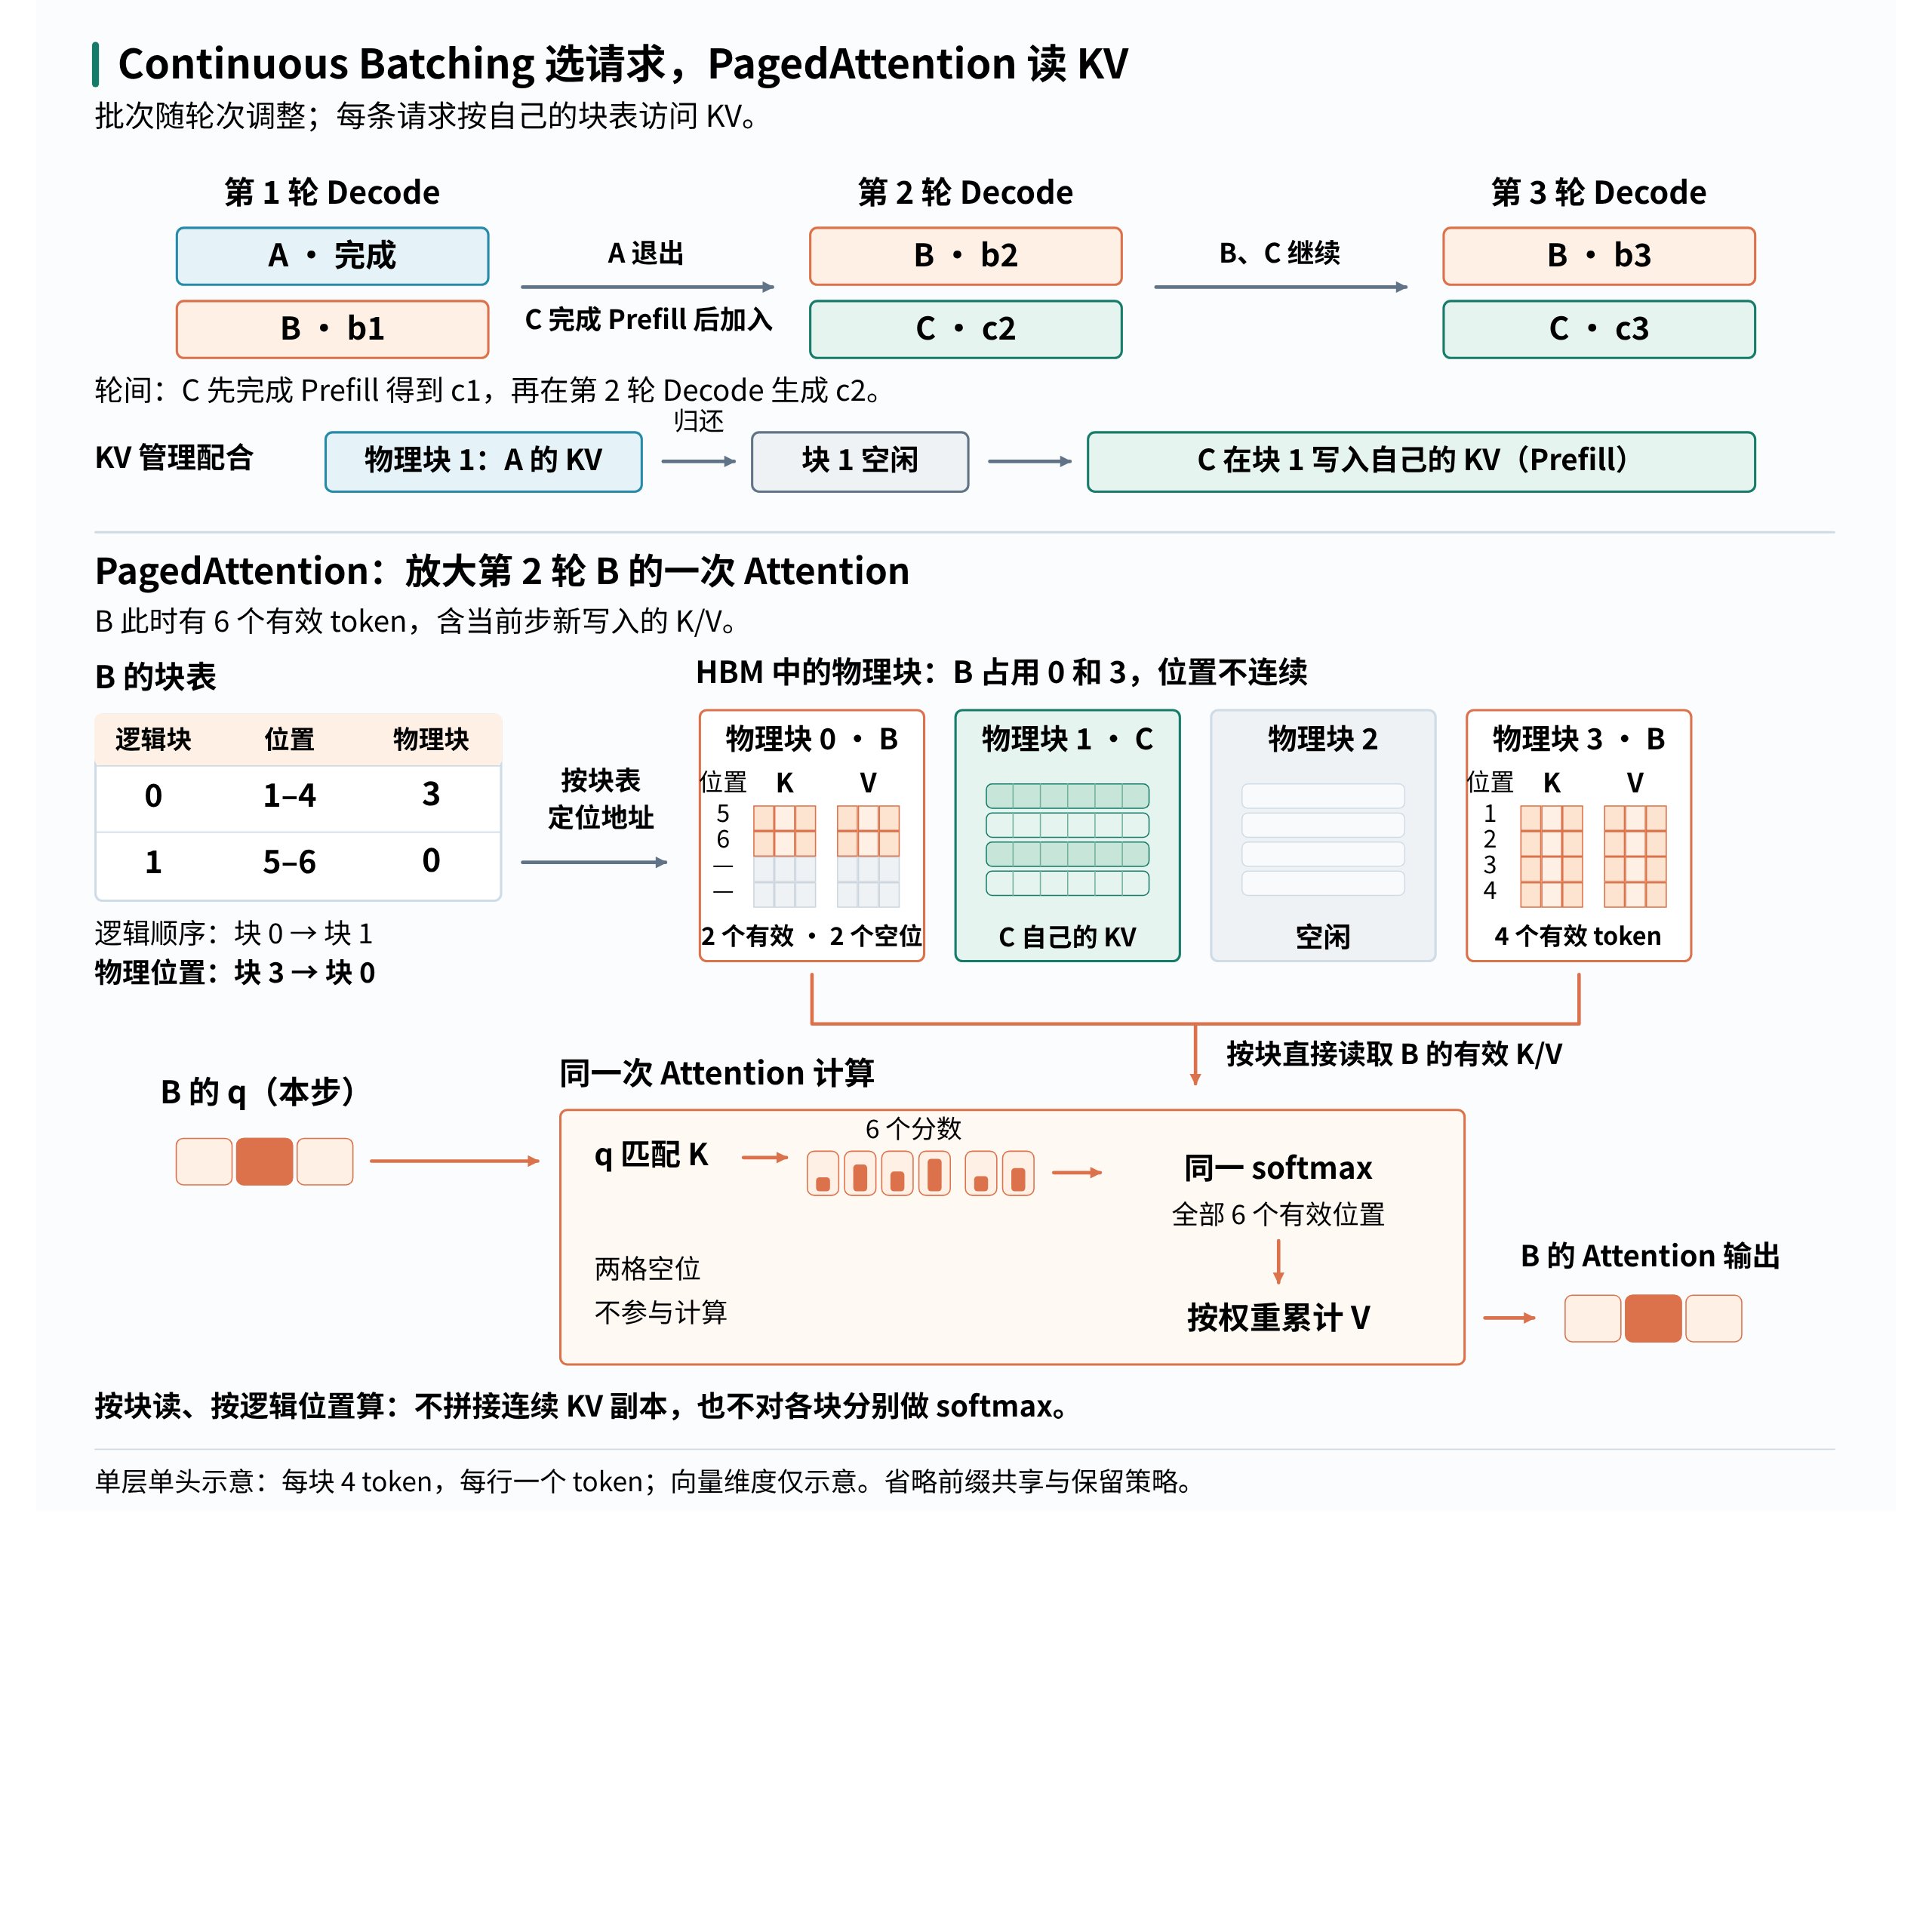
图中,A 结束后,C 把自己的 KV 写进回收的块;B 则继续按块表读取自己的历史 KV。批次成员在变,KV 空间也随之周转。这样,服务就有机会在同样的显存里容纳更多请求。省下的是预留和碎片空间,每个 token 的 K/V 大小没有改变。实际回收时,还要确认块已不再被请求引用或保留。
不过,更多请求一起算,也会增加这一轮的计算量和 KV 读写量。一轮执行得越久,每条请求等下一个 token 的时间就越长。缩小批次有机会降低这段等待,但权重搬运成本也会由更少的请求分摊。提高总吞吐与降低单请求延迟,是两个不同的目标。vLLM 的性能配置也区分了这两种取向。
Fast 模式:速度与成本的取舍
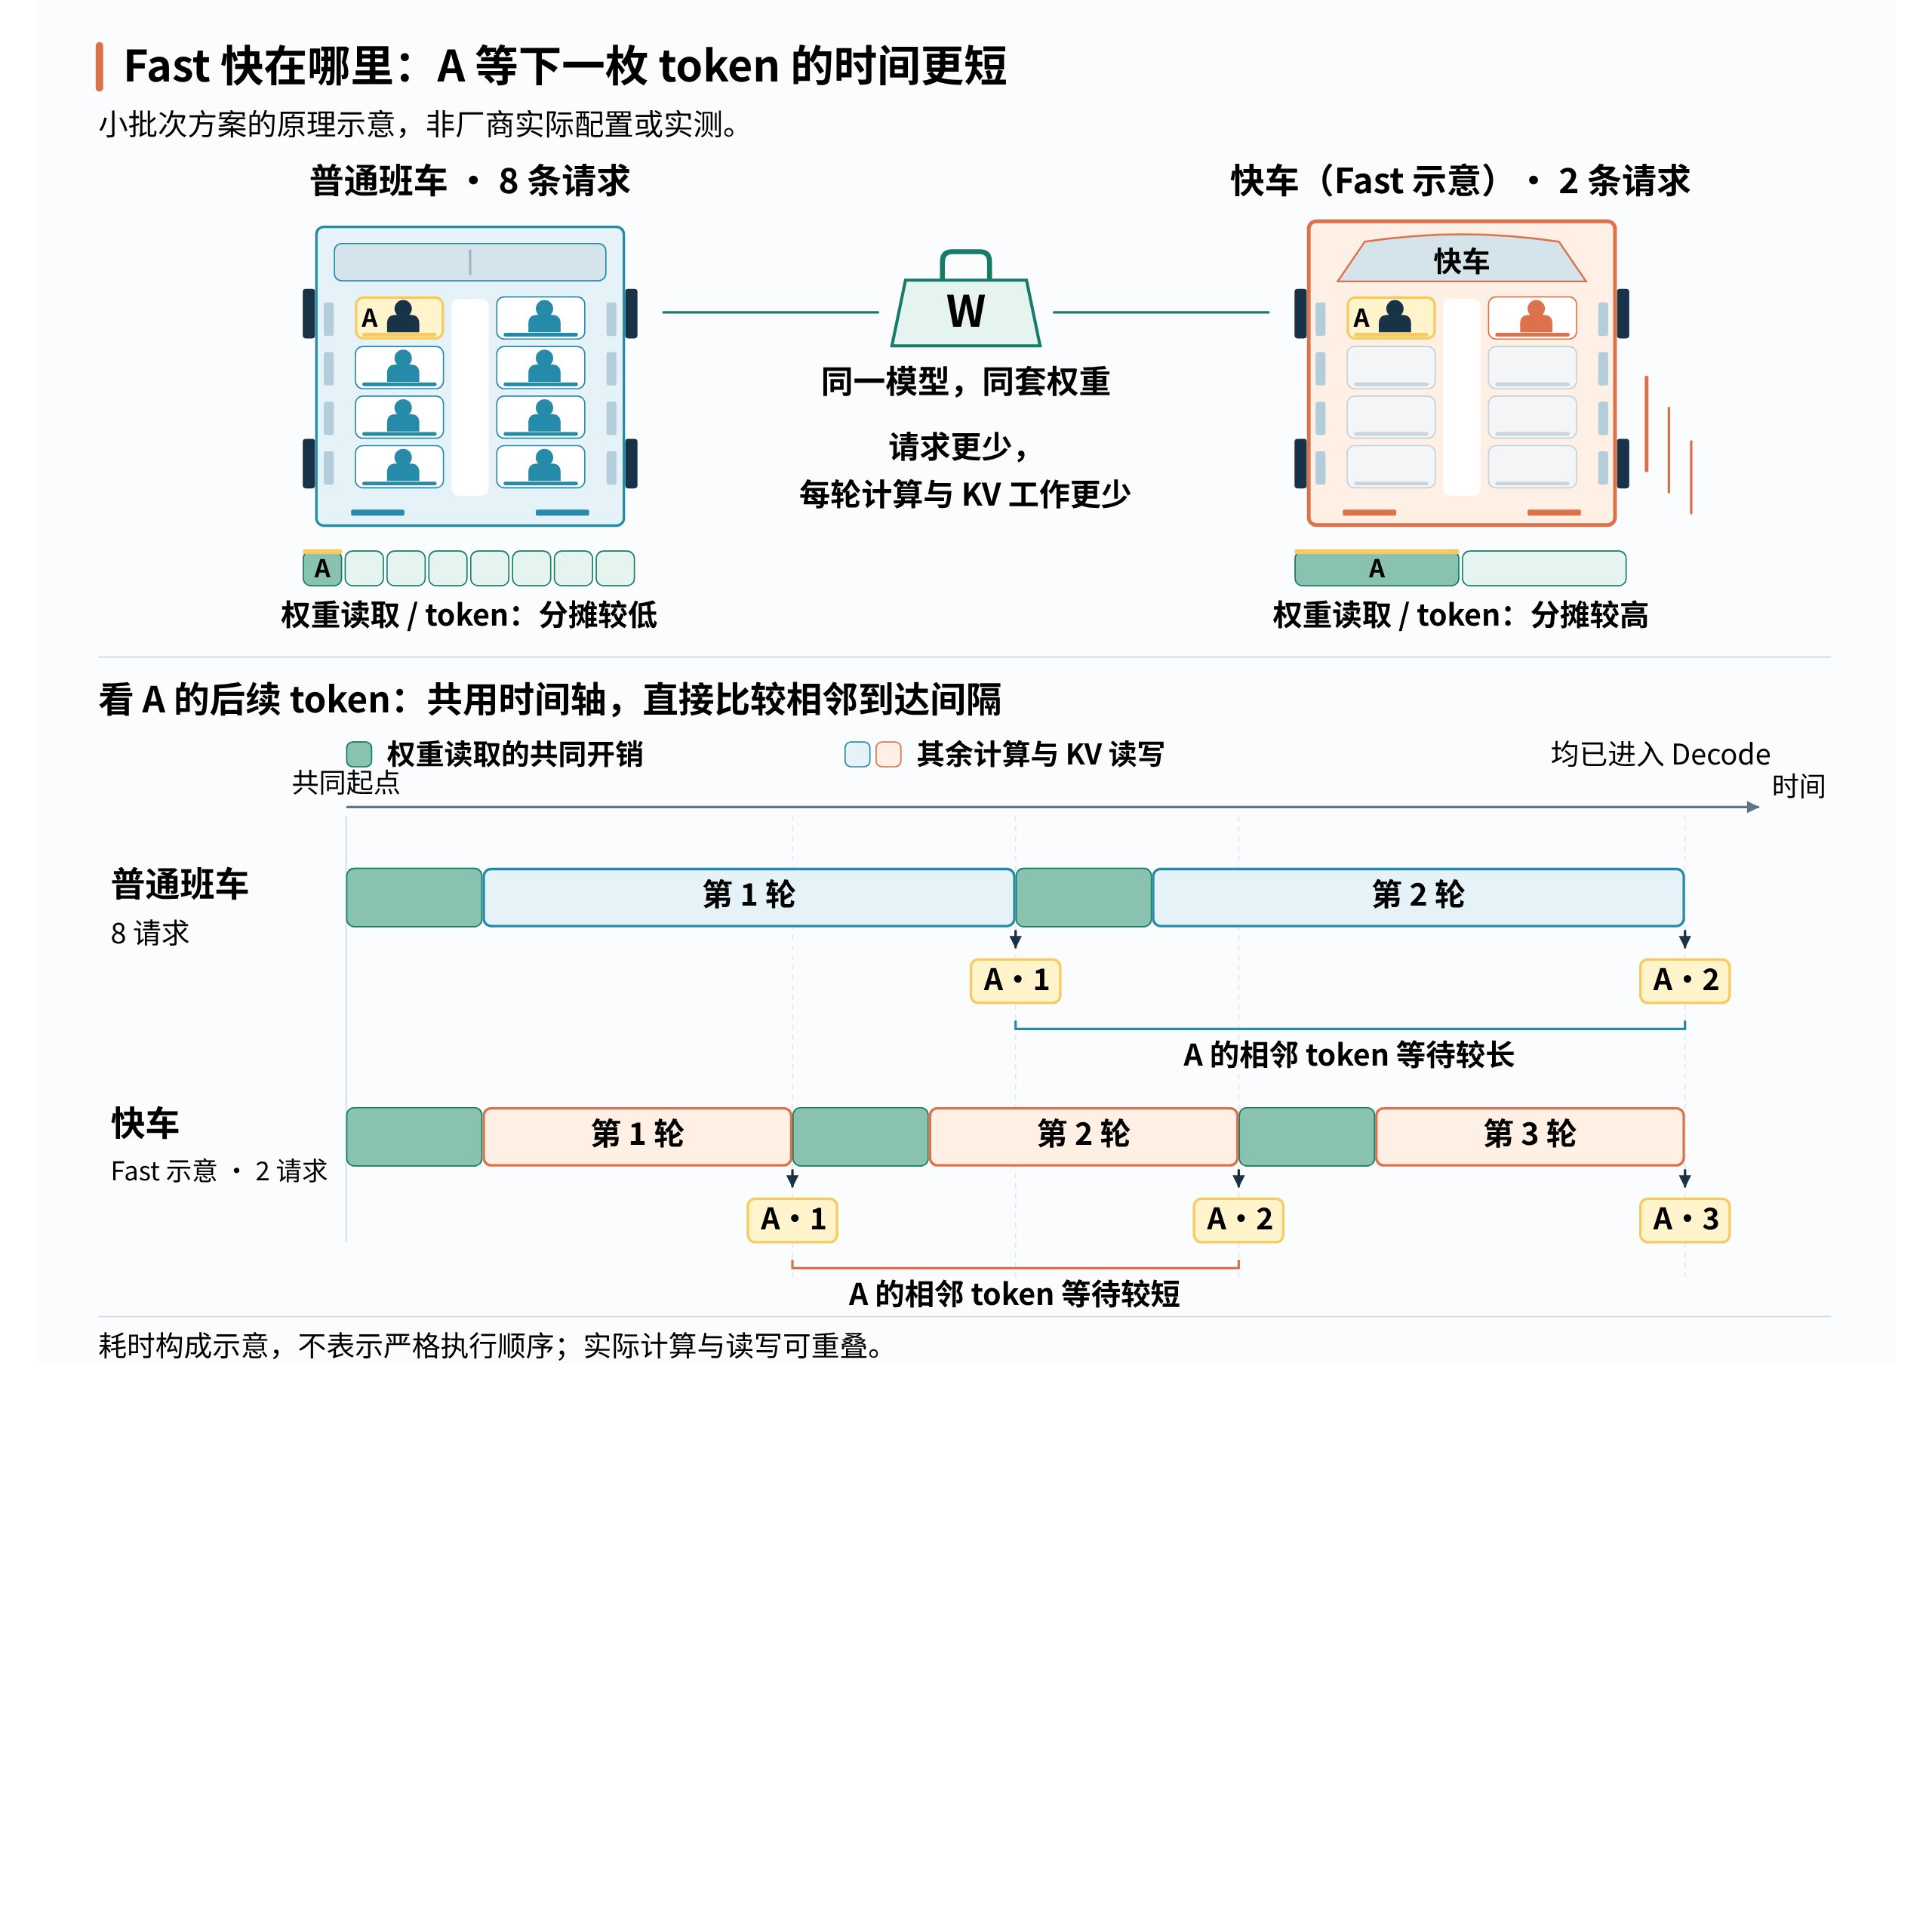
上面的取舍,可以想成普通班车和快车。一张价目表,看穿大模型的底牌这篇文章把 Fast 形容为“为你买了一节更空的车厢”。可以把一组 GPU 想成一辆车,每条请求是一位乘客,权重读取就是一次出车要付的固定开销。
只看这笔开销,一轮带 8 位乘客,每人分担八分之一;如果只带 2 位,每人就分担二分之一。还是同一套权重,分摊的人少了,每个输出 token 承担的权重读取成本就高了。
对应到 GPU,每增加一条请求,还要多做计算、多读写它的 KV。下图用同一时间刻度对比两种批次:一轮处理得更快,同一位用户拿到相邻两个 token 的间隔就更短。若权重读取已是主要瓶颈,缩小批次的收益也可能有限。
2.6 Chunked Prefill 与 PD 分离:长输入的调度方式
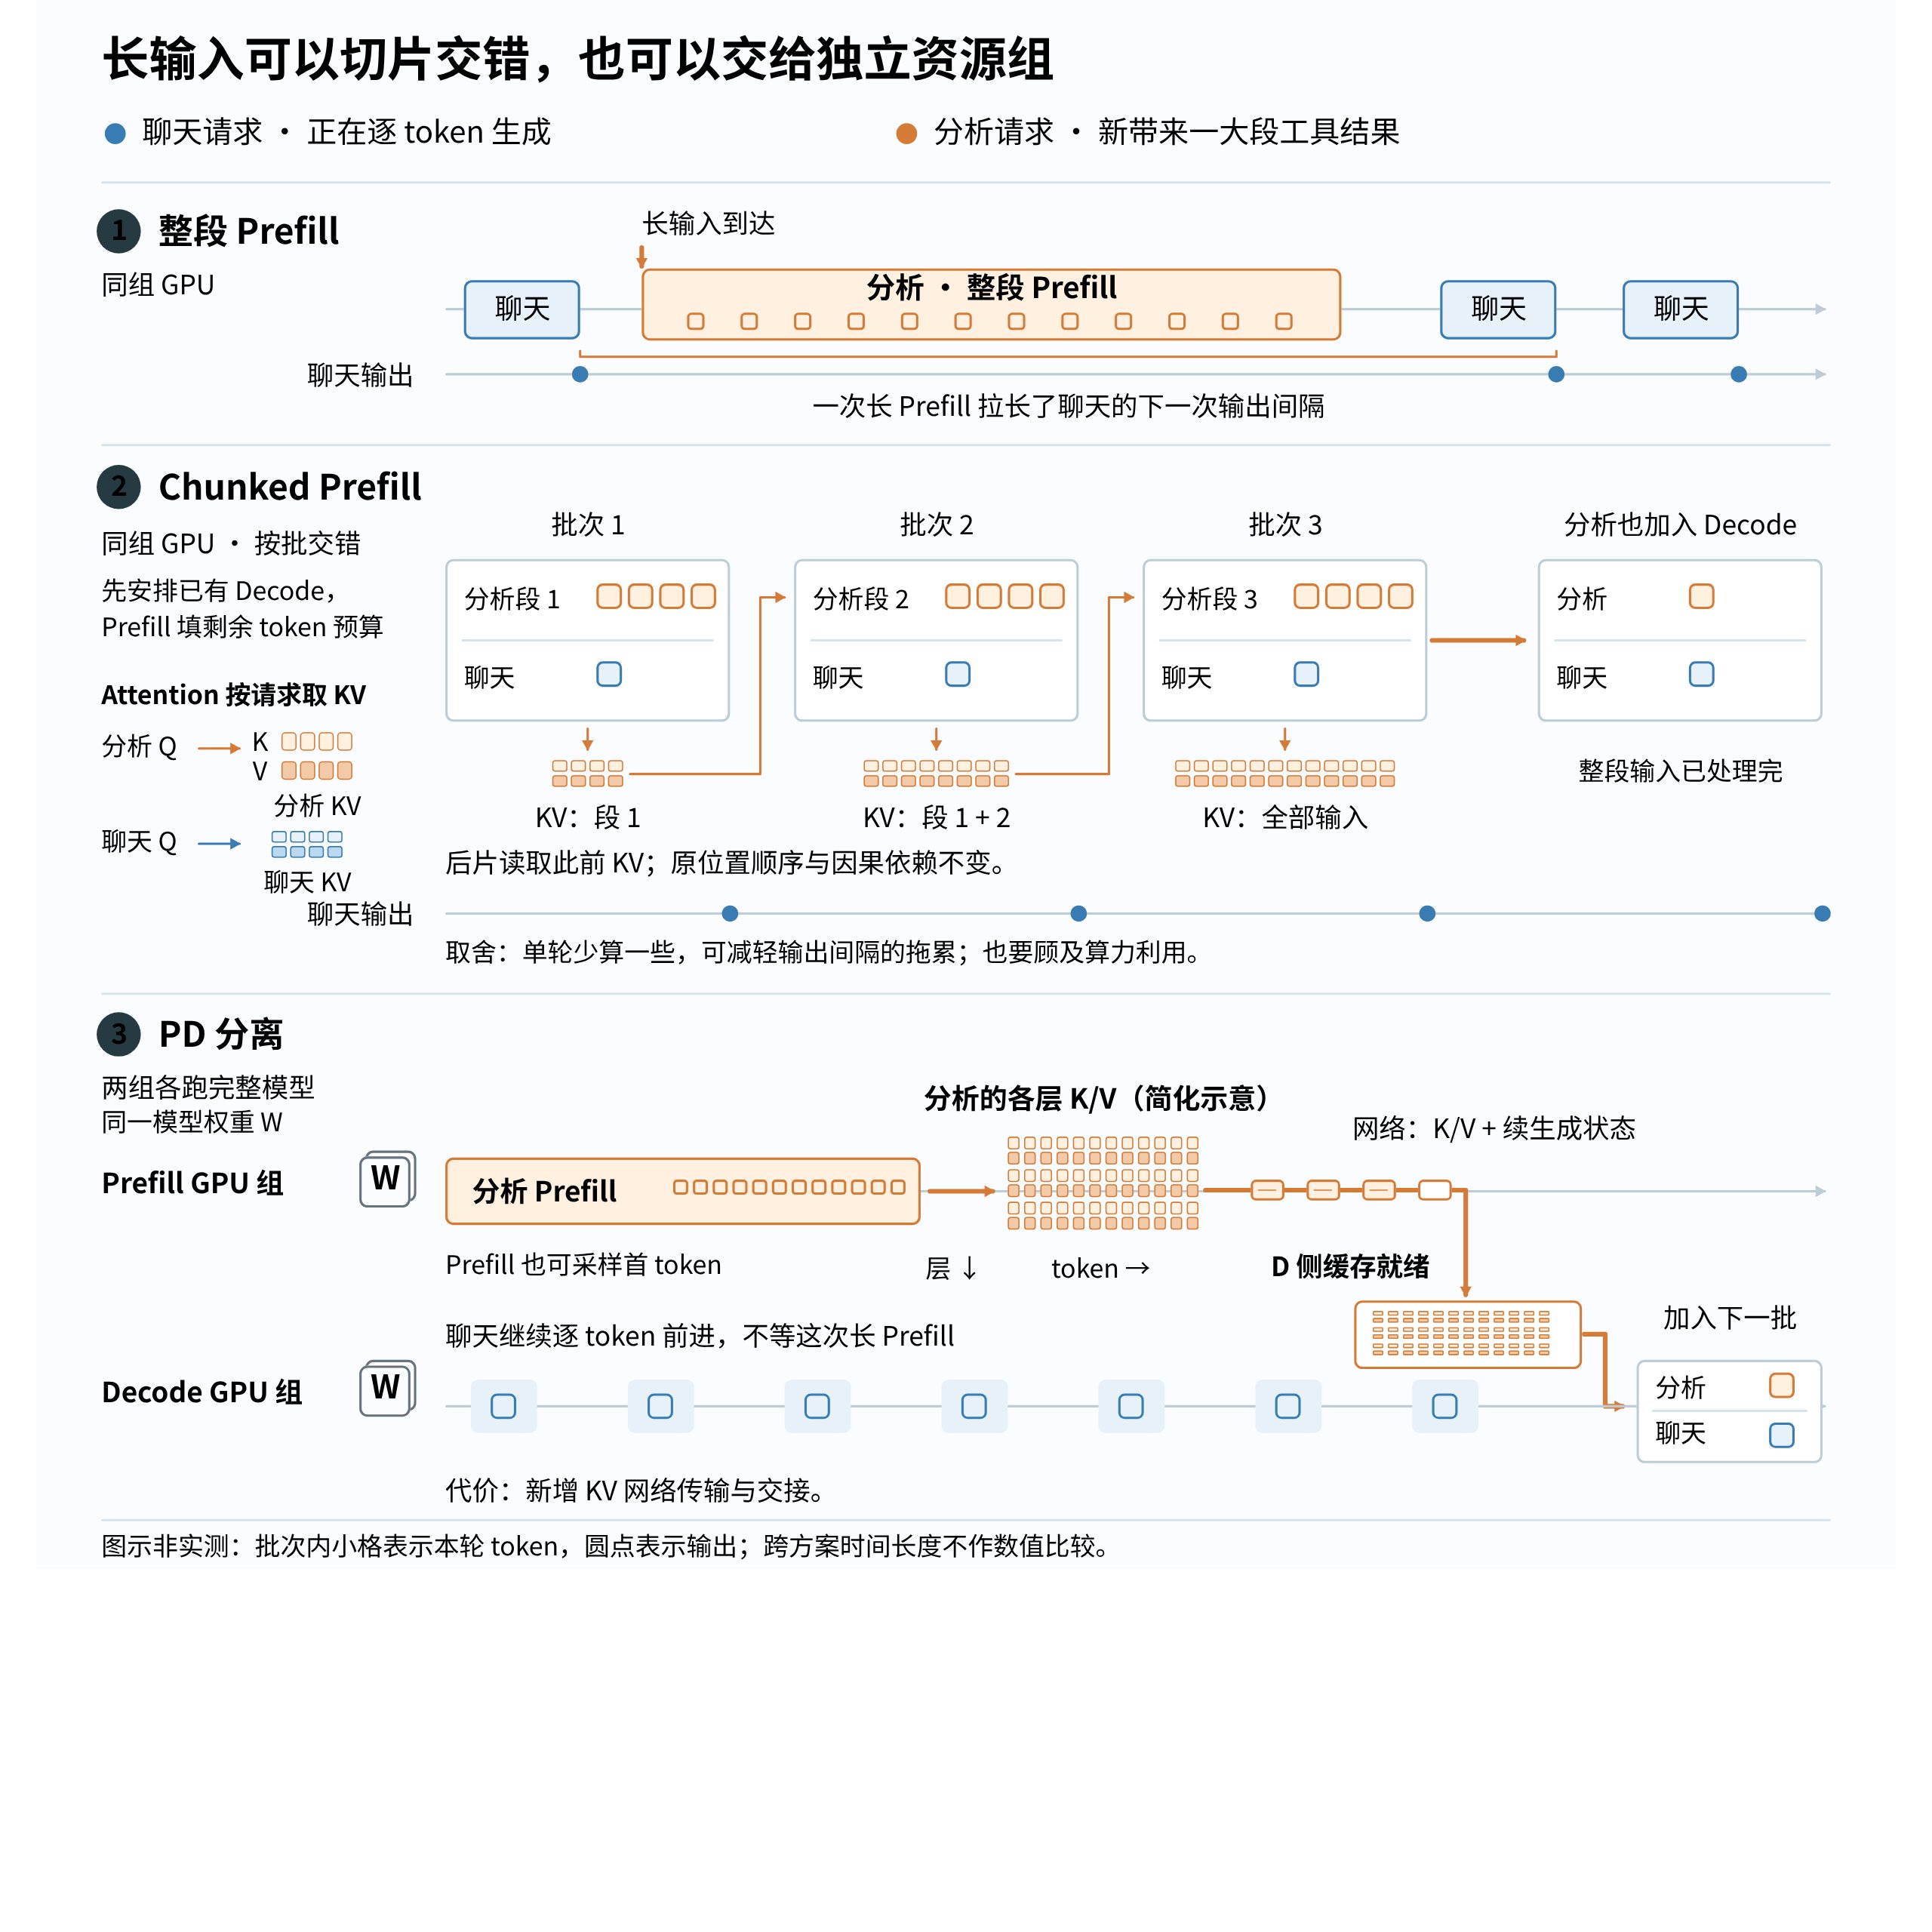
同一组 GPU 上,聊天请求正在输出,分析请求却刚带来一大段工具结果,要先做 Prefill。如果长输入一口气算完,聊天就可能停顿——像收银台被满载购物车占住,只买一瓶水的人也得等。
Chunked Prefill:让长输入分几轮算
把长输入分成几段,就像大单分几篮结账。每轮先安排 Decode,再把 Prefill 片段放进剩余 token 预算一起算。后段接着用前段的 KV,整段输入读完才开始回答。
片段小,聊天受单轮计算的拖累通常更少;但分析请求的首 token 可能更晚,GPU 利用率也可能下降。参见 vLLM 调度说明。
PD 分离:把读题和作答交给两组 GPU
Prefill 实例处理输入,Decode 实例接着生成。两边加载同一模型,通过传递各层 KV 和继续生成所需的状态来交接;接收就绪后,分析请求加入 Decode 批次。
聊天请求由 Decode 侧继续处理,长 Prefill 带来的干扰更容易隔开;代价是多了 KV 传输和交接开销,是否划算取决于负载与互联带宽。参见 PD 分离说明。
2.7 前缀缓存:跨请求复用与命中条件
Agent 调完工具,把结果追加到对话里,又发起一次请求。系统提示、工具定义和前面的对话常常没变,上一轮的 KV 如果还留着,这一轮就能接着用。这是 Prefix Caching(前缀缓存)。它复用的是从开头连续相同的一段,因为每个位置的 K/V 都受前文影响。
vLLM 用分块哈希来检查前文是否相同:每块把自己的 token 和前一块的哈希一起算进去。前面的内容一变,后面的索引也跟着变。
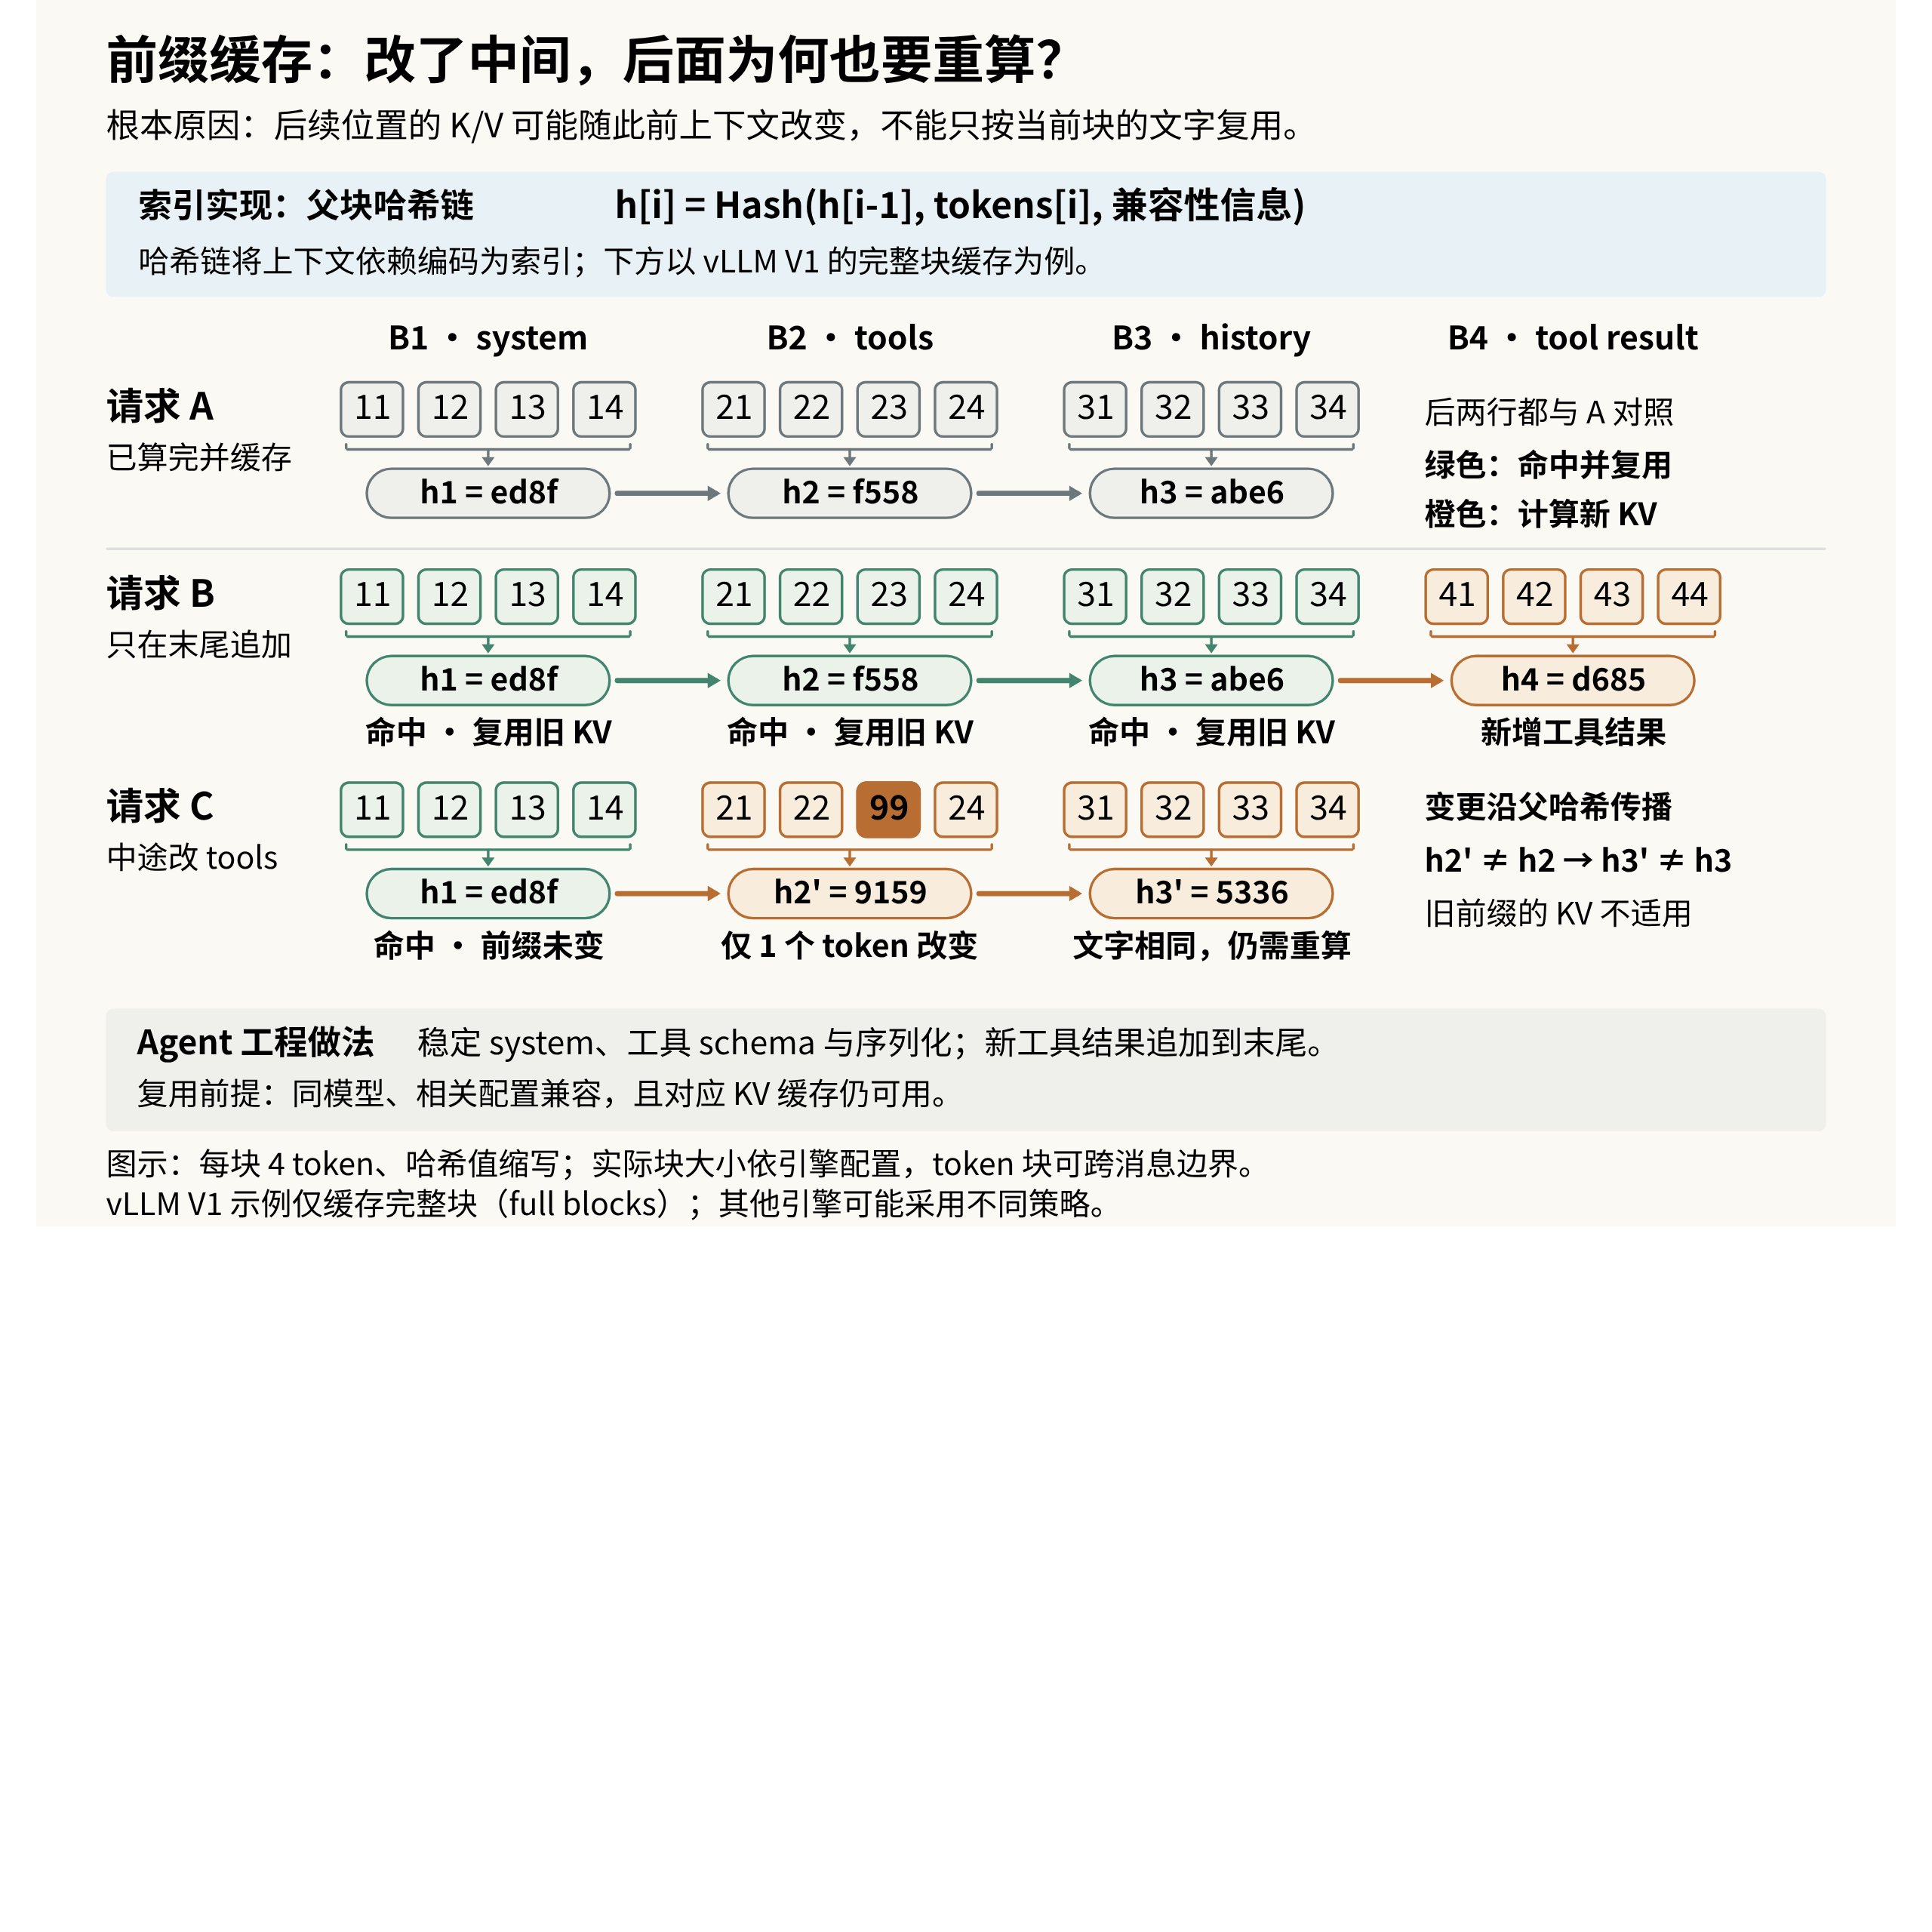
这里比的是模型实际收到的 token。工具定义换个顺序、角色分隔符不同、序列化格式变化,都可能让前缀变短。即便 token 相同,也得模型和相关配置兼容、缓存还在,而且这次请求能读到它。命中以后省下的是对应输入的重复计算,新的回答仍要生成。细节见自动前缀缓存和分块哈希设计。
GitHub 上有个以高缓存命中率为卖点的热门项目,叫 DeepSeek-Reasonix。它是一款开源编程 Agent,早期围绕 DeepSeek 做适配,能读写代码、调用工具并持续执行任务。
它在上下文组织上做了专门设计:系统提示和工具定义固定,历史消息按顺序追加,临时状态单独管理,减少前缀被改动的机会。项目公布的2026 年 5 月 1 日、单用户单日记录中,输入缓存命中率达到了 99.82%。
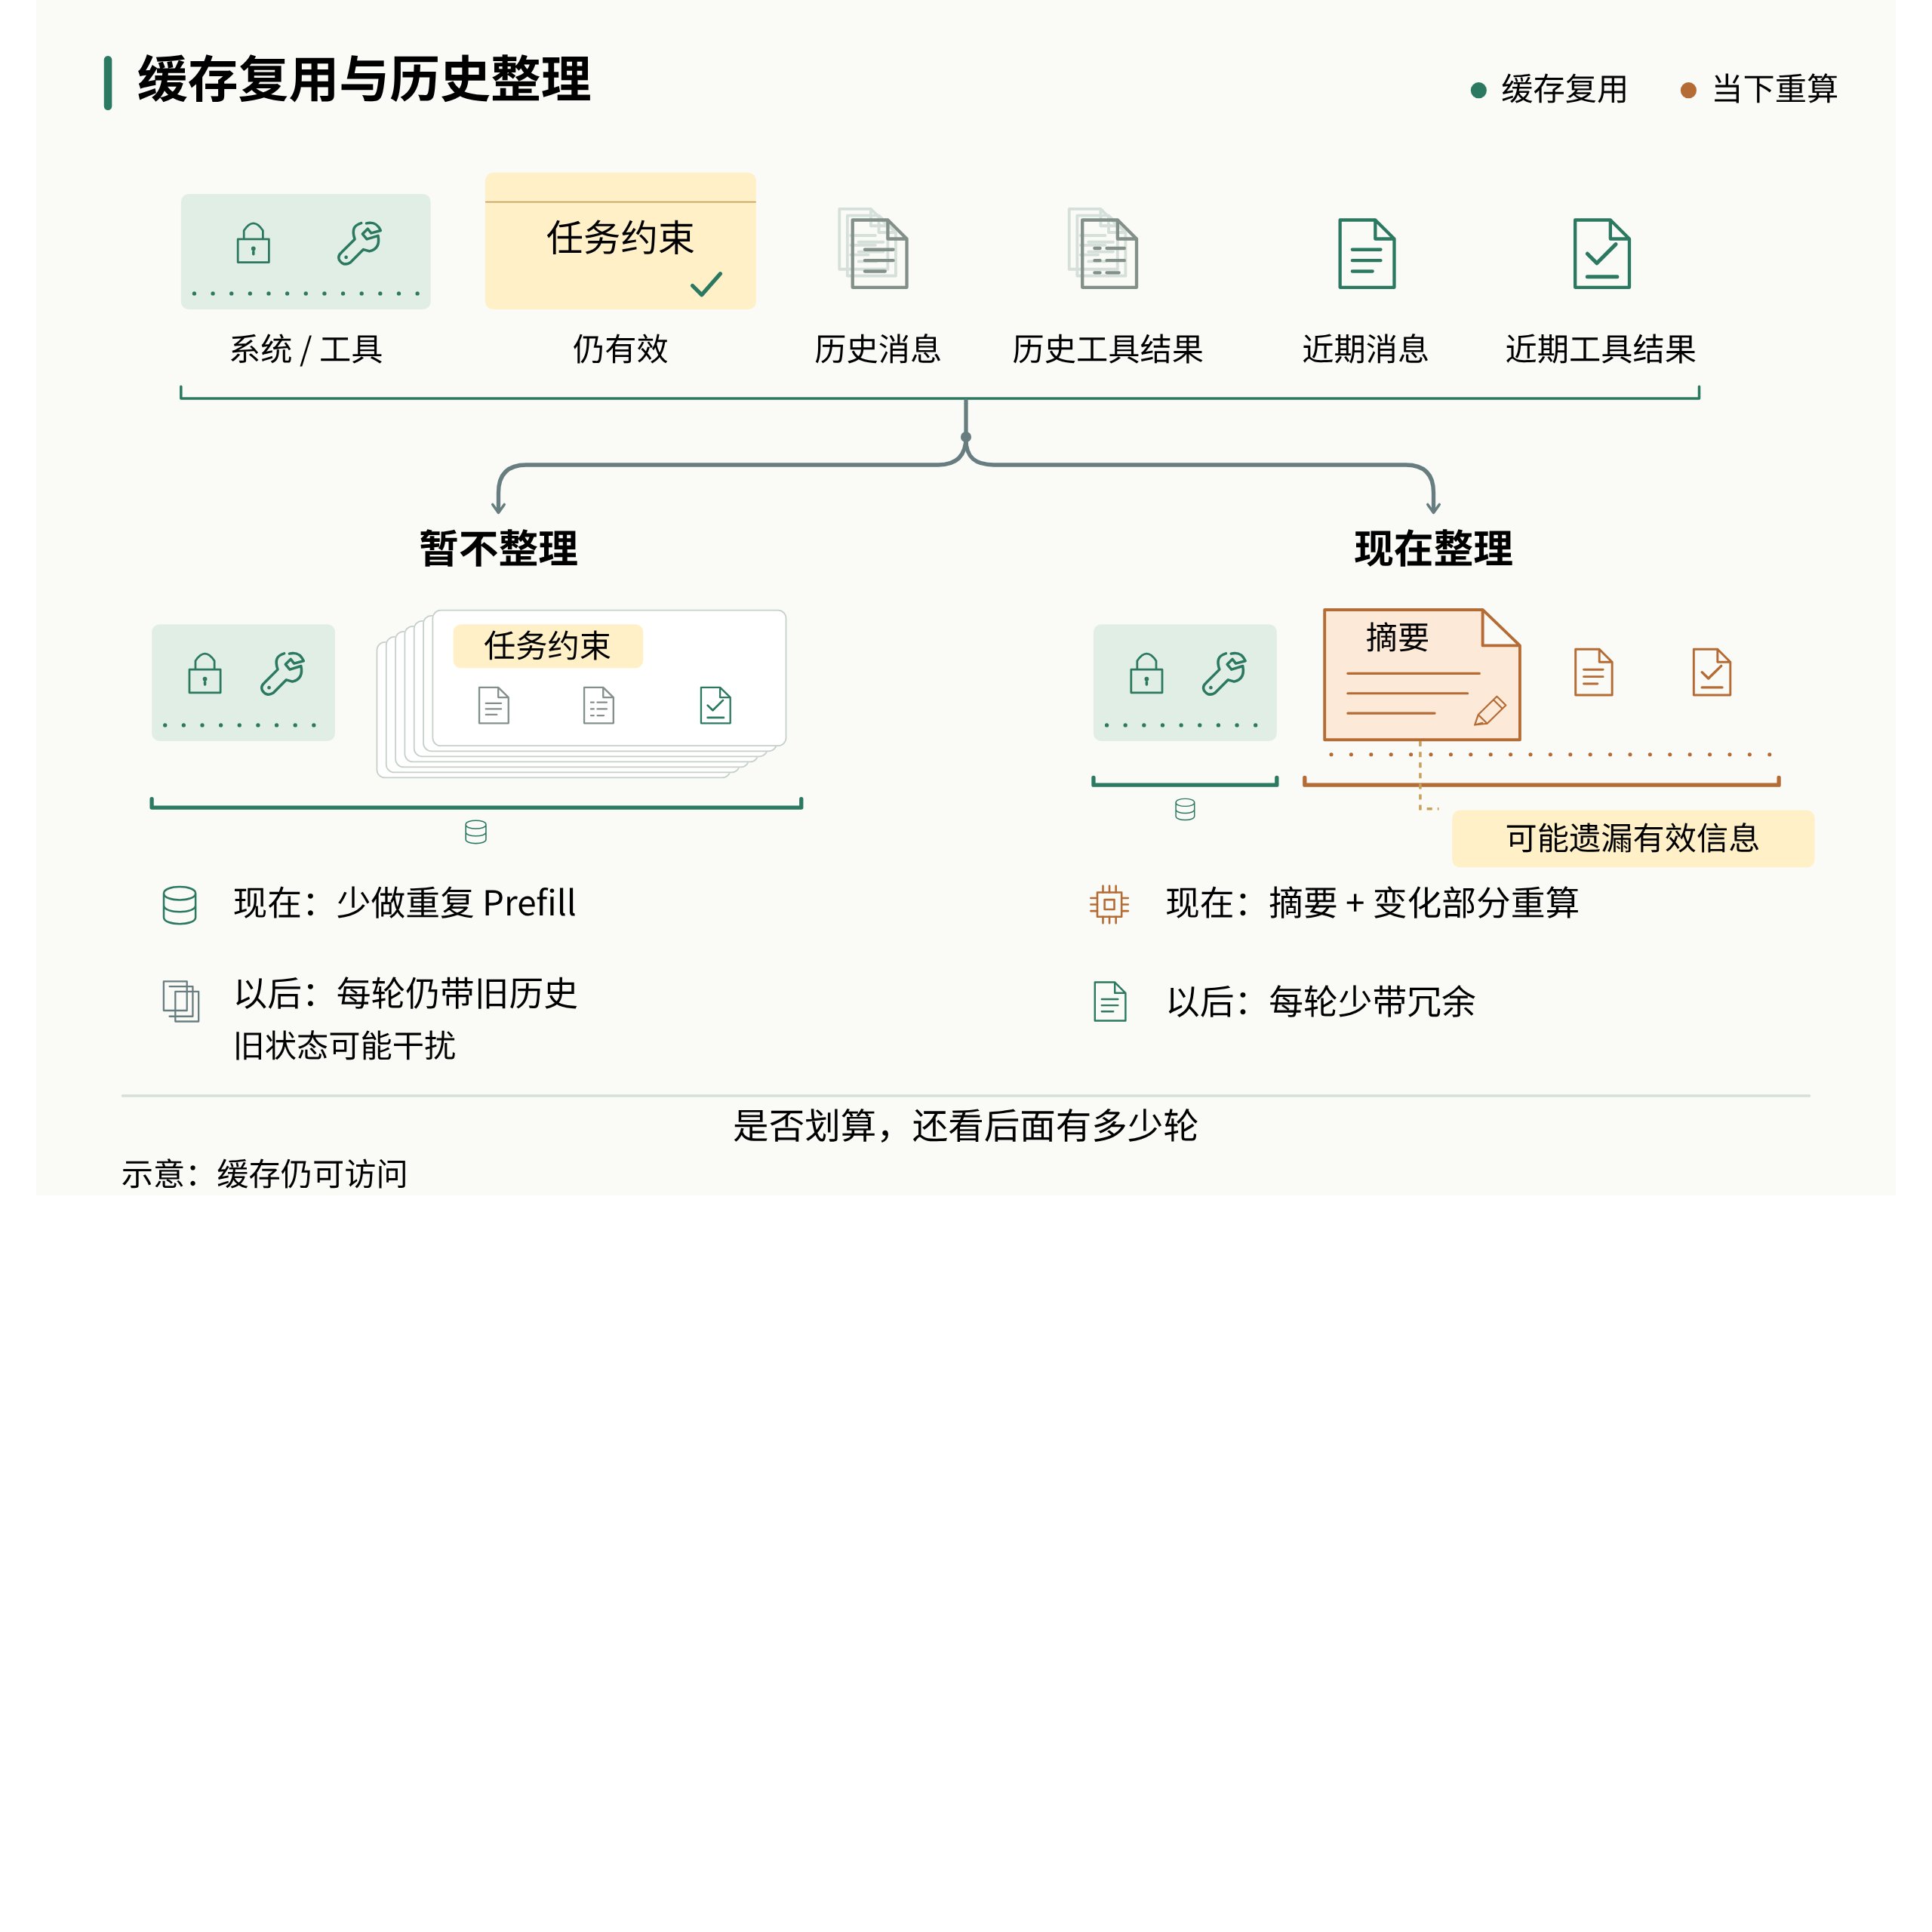
不过,为了保住缓存而迟迟不整理历史,也有代价。原有前缀可以继续复用,冗余和过时信息也会一直留在上下文里。它们即使命中缓存,仍会参与后续推理,可能干扰模型判断。
整理历史能减少后续输入,但要先付摘要和部分 KV 重算的开销;压缩过度又可能遗漏有效信息。整理得早,缓存要更早重建;整理得晚,冗余内容就多留几轮。
结语
感兴趣可阅读https://vllm.ai/,源码是最好的学习材料