CS329A Lecture2:Test-time Compute Scaling
Table of Contents
CS329A 全名是 Self-Improving AI Agents,是 Stanford 开设的一门研究型课程,关注 Agent 怎样从自己的尝试和环境反馈中继续变好。Lecture 2 先把范围缩到一次任务内部:模型已经训练完,参数不再变化,但回答问题时仍可以多花一些计算,例如多生成几份答案、修改上一份答案,或请另一个模型检查结果。这些额外计算统称为 test-time compute。它不会让模型当场学会新能力,只是让 Agent 有更多机会生成、检查和修改答案。这篇笔记把四篇论文串在一起,分别讨论重复采样、单题预算分配、平均曲线的幂律现象,以及由生成、筛选和融合组成的推理流程搜索。
四篇论文各自回答什么?
可以从四个观察尺度来读这四篇论文。Large Language Monkeys 只看候选集合:多生成几份答案有没有用。Snell 等人用两组独立实验研究一道题的预算,一组比较从头生成和修改旧答案,另一组用评分器搜索解题路径。Power Laws 转向整个题库,解释许多题取平均后为什么会出现幂律。最后,Archon 看整套 Agent 流程,研究多个模型和处理步骤应该怎样组合。它们讨论的是相关问题,并没有共同组成一套四步算法。
它们使用的预算单位也不同:有的统计答案数量,有的统计生成 token(模型处理文本时使用的基本片段)或 FLOPs,有的统计模型调用次数。因此,后文只比较思路,不直接比较这些数字。
原文:Monkeys、Snell et al.、Power Laws、Archon。
1. 多答几次,正确答案更容易出现吗?
Brown et al., Large Language Monkeys: Scaling Inference Compute with Repeated Sampling,2024。arXiv:2407 .21787
先从最简单的重复采样说起。假设模型每次解出一道题的概率只有 1%,只答一次当然很悬;如果每次尝试彼此独立,连续答 100 次,候选里至少出现一次正确答案的概率约为 63%。模型没有变,变化的只是尝试次数。
Large Language Monkeys 把这个办法推到了很大的规模:每道题生成 10、100,甚至 10,000 个独立样本。样本之间互相看不到,也不会根据报错修改前面的答案。刻意去掉复杂的搜索策略,正是为了看清增加候选数量本身能带来什么。
先分清“出现过正确答案”和“最终选对”
论文先故意不管最后提交哪份答案,只问一件事:模型生成的 份答案里,有没有至少一份正确?论文把这种“候选中至少出现一个正确答案”叫作候选覆盖率(coverage)。代码生成论文里常见的 pass@k 也是这个意思。
例如,一个代码 agent 生成了 10 份补丁,其中只有第七份能修好 bug。对候选覆盖率来说,这道题已经成功;但如果系统最后提交了第三份,用户拿到的仍然是错误代码。候选覆盖率只看正确答案是否出现过,最终正确率才看系统交出了什么。
对某一道题,如果每次独立采样的成功率都是 ,那么 次里至少成功一次的概率是:
这个式子表达的直觉很简单:每次尝试都多给模型一次答对的机会。实际实验并不知道真实的 ,只能先生成 份答案,看看其中有 份正确,再用下面的公式估计 pass@k。公式本身不是理解后文的前提,它只是说明论文怎样从有限样本得到曲线。
拖动下面的 可以看到,容易题很快就会饱和;真正消耗预算的,是那些模型偶尔能答对、但成功率很低的题。
公式是 1 − (1 − p)k,假设每次独立。当 k = 10,000 时,pass@k 为 。 这条曲线只描述成功率固定的一道题;数据集平均还会受到题目间差异的影响。
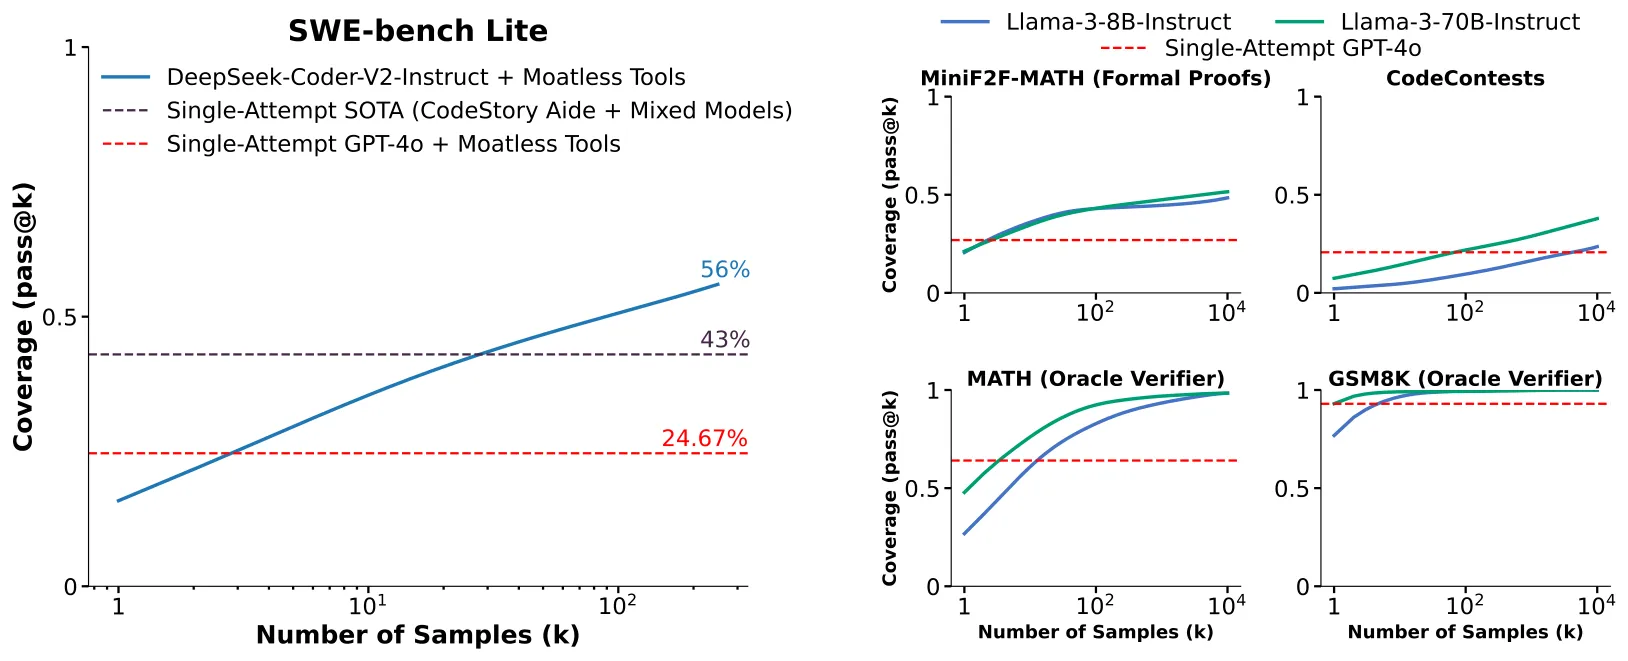
不过,采样再多也不能证明一道题“绝对不会做”。开源的 Pythia 模型家族在代码竞赛基准 CodeContests 上,每道题尝试 10,000 次,仍然没有出现正确答案。这只能说明实验没有观察到成功样本;有限采样分不清 ,还是 很小、暂时没有抽中。
系统怎样找出正确答案?
还是看刚才的代码 agent。十份补丁摆在面前,系统需要某种办法判断第七份才是对的。最理想的情况是有一套可靠测试:每份补丁都跑一遍,谁通过就提交谁。形式化证明也类似,Lean 这类证明检查器可以明确告诉你证明是否成立。
现实往往没这么省心。测试可能不完整,也可能只在评测结束后才公开。研究者可以拿隐藏测试回头检查十份补丁,于是知道“正确补丁曾经出现过”;agent 在真正提交时看不到这些测试,自然不能靠它们挑出第七份。数学题也一样:评测结束后,研究者可以拿标准答案核对最后一个数字;真正作答时,agent 看不到标准答案,只能依靠投票或模型评分来猜该提交哪一份。
论文中会看到几种“裁判”的名字。规则检查器(checker)是按明确规则运行的程序,比如代码测试和 Lean 检查器;结果奖励模型(outcome reward model,ORM)或 LLM 评分器(verifier)则让另一个模型给答案打分。后者更灵活,但它也可能把错误答案评成高分。
SWE-bench Lite 的结果把这个差别表现得很清楚。这个基准让 agent 修复真实代码仓库中的问题。DeepSeek-Coder-V2-Instruct 配合 Moatless Tools——一套帮助模型浏览仓库、修改文件和运行测试的软件修复 Agent 框架——只运行一条轨迹时,大约每 100 个问题能解决 16 个;每个问题改为运行 250 条不同轨迹后,大约 56 个问题至少出现过一条正确轨迹。当时拿来比较的单次方法,大约能解决每 100 个问题中的 43 个。
这里的一条轨迹不是一句短回答,而是 agent 浏览仓库、修改代码、运行测试的完整过程。因此,56% 的意思是“100 个问题里,有 56 个曾经跑出过正确方案”,不是系统已经能自动交对 56 个答案。
候选越多,筛选方法未必越准
GSM8K 和 MATH 都是数学题,没有程序能够可靠检查完整推理过程。作者只能尝试几种近似办法:多数投票选择出现次数最多的最终答案;ORM best-of-N 让奖励模型给每份答案打分,再挑最高分;reward 加权投票则让高分答案拥有更大的票数。
这些方法看到前 100 个候选时还有进步,继续增加候选后却几乎不再变化,候选覆盖率仍在上涨。MATH 上,当候选从 100 个增加到 10,000 个时,8B 模型的候选覆盖率从 82.9% 增至 98.44%,最终选对的比例却只从 40.50% 变到 41.41%。模型确实生成了更多正确答案,只是挑答案的方法没有把它们找出来。
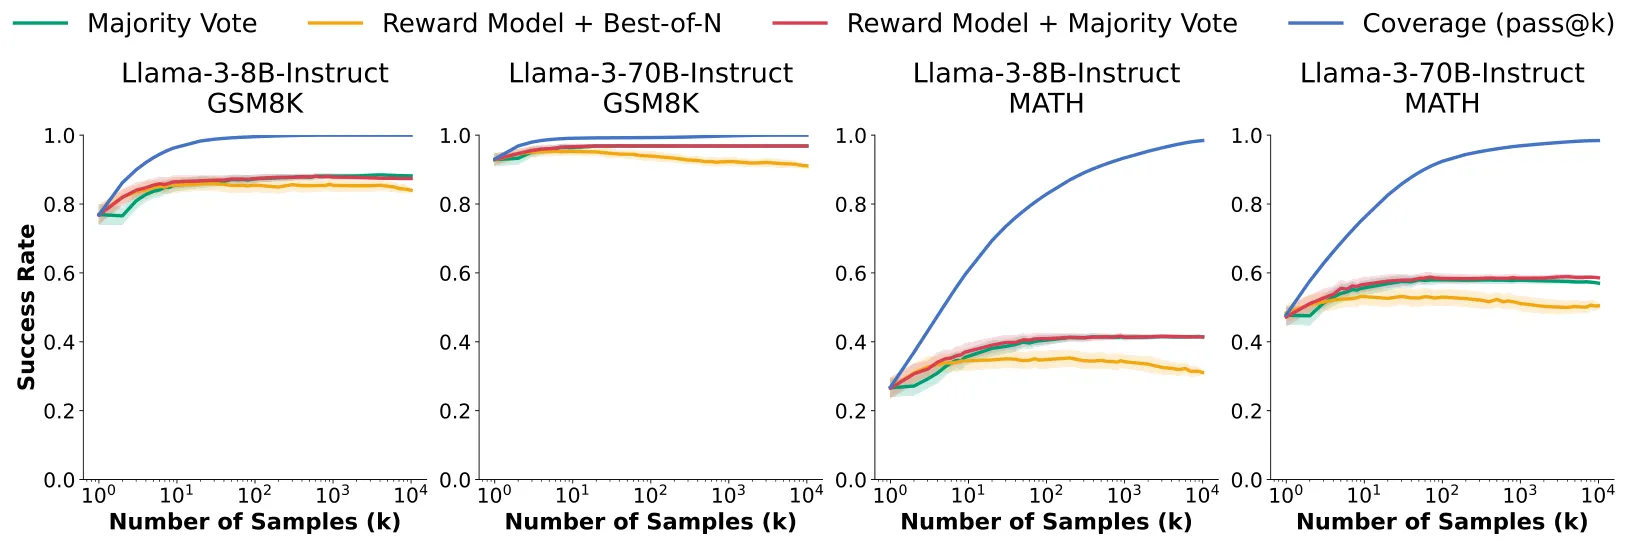
多数投票的问题最好理解。假设模型答了 100 次,正确答案只出现 1 次,某个常见错误却出现了 40 次,多数投票必然会选择错误答案。重复采样提高了候选覆盖率,没有改变多数投票的判断方式。
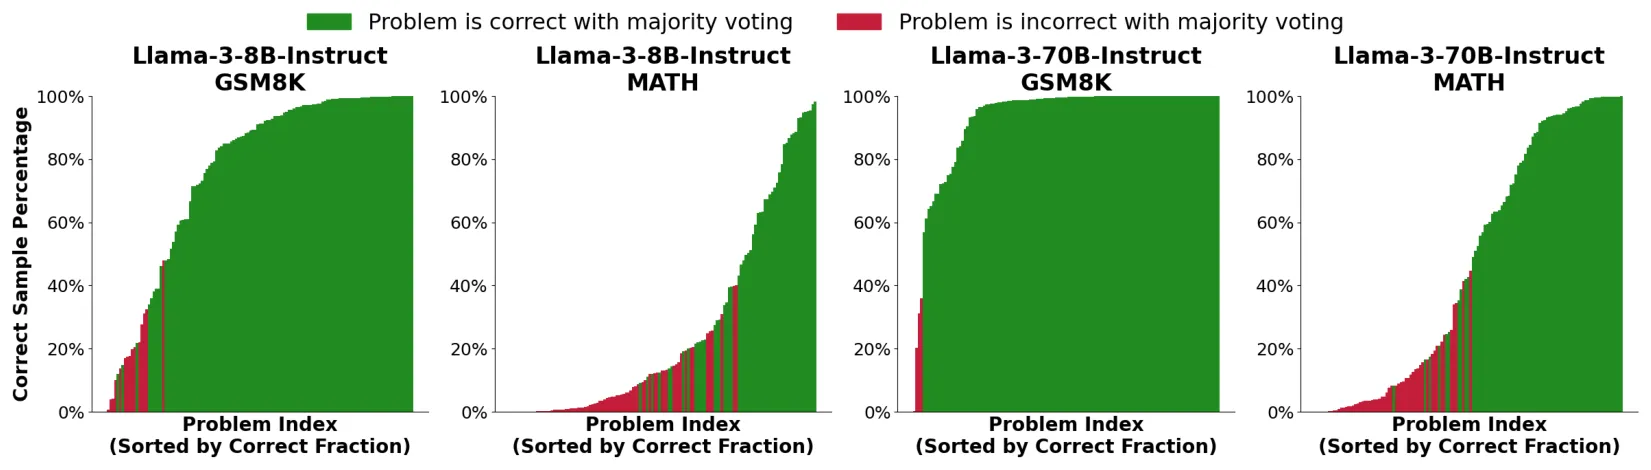
这些偶尔出现的正确答案也不只是碰巧猜中数字。作者人工检查了 105 条最终答案正确的 GSM8K 推理链,超过 90% 的过程是有效的。问题确实出在“没有认出来”。
自动测试也可能错判正确程序
即使有自动测试,也不能把测试结果当成绝对真相。SWE-bench Lite 的 300 道题里,有 34 道会偶尔通过、偶尔失败,这类不稳定测试通常叫 flaky test。去掉这些题后,候选覆盖率仍然会随采样次数上升。CodeContests 也会错杀正确程序:122 道带 Python3 官方答案的题里,有 35 道至少存在一个“官方正确、测试却不通过”的程序。
所以,候选覆盖率回答的是“模型有没有生成过正确答案”,最终成绩回答的才是“系统能不能把正确答案交出来”。两者之间隔着筛选,而筛选本身也可能犯错。
挑答案只是第一笔额外开销。多跑一次模型同样要花钱,而且小模型和大模型跑一次的成本差很多。于是,重复采样还需要回答另一个问题:同一笔预算究竟该买很多次便宜尝试,还是少数几次更强的尝试?
同样预算,小模型多答还是大模型少答?
同样生成 100 份答案,8B 模型和 70B 模型的计算量相差很大。这里的 B 表示约十亿个参数:70B 模型的参数量远大于 8B,不能只拿“采样次数”比较。论文于是改用总推理 FLOPs 衡量预算,可以把它简单理解为模型完成这些回答一共做了多少计算。
在论文比较的 Llama 3 模型和这些基准上,形式化证明、算术和数学竞赛题更适合让 8B 模型多答几次;到了 CodeContests,70B 模型少答几次反而更好。这个结果不能直接推广到所有代码任务或所有模型家族。
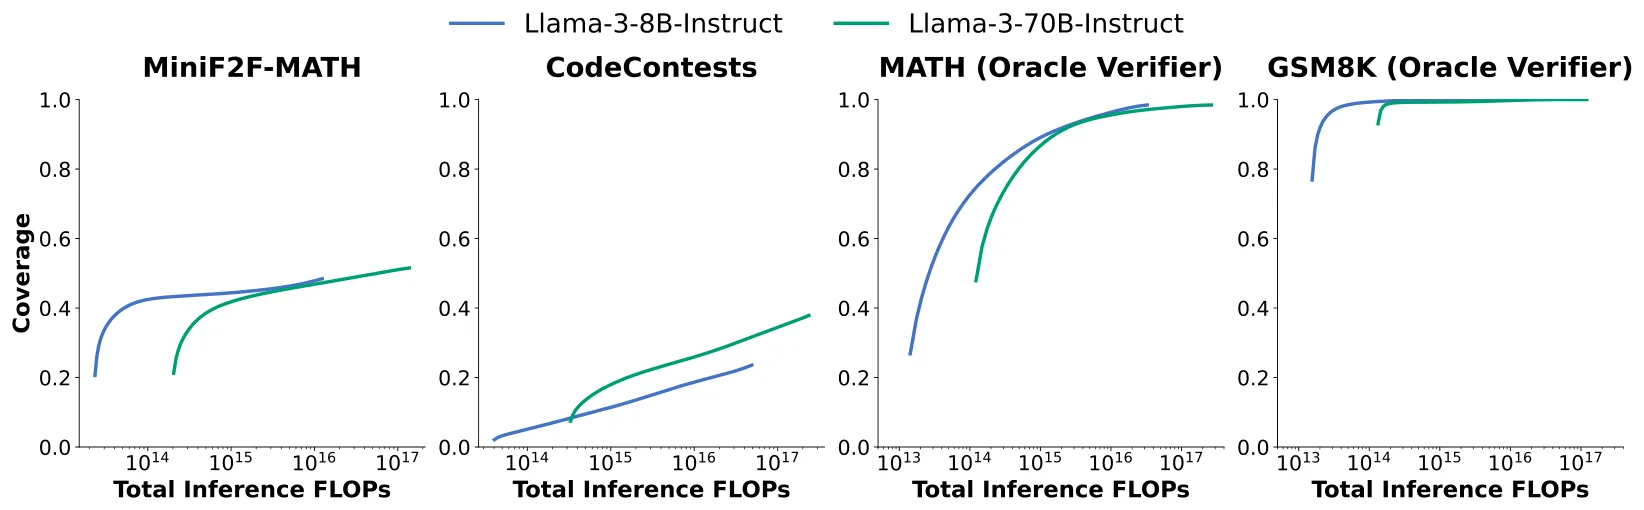
SWE-bench Lite 的 API 成本实验给了一个更直观的例子。保持 Moatless Tools 不变,DeepSeek 每题运行 5 条轨迹,平均约 0.036 美元,解决率是 29.62%;GPT-4o 和 Claude 3.5 Sonnet 各运行一次,成本更高,解决率分别是 24.0% 和 26.7%。
这些价格只属于论文实验时期,现在很可能已经变化。价格会变,比较方法不会:单次能力、单价和调用次数必须放进同一张账里。
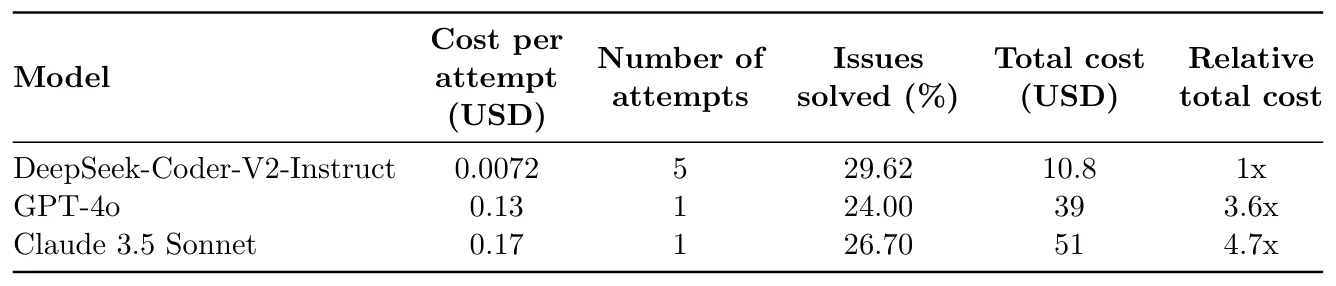
真实成本也不只是“单价乘以尝试次数”。多次回答使用相同题干时,可以复用部分计算,降低平均成本;长轨迹、检查候选和等待结果,又会让整套系统变慢、变贵。
同一家族中,大模型通常用更少采样达到相近覆盖率
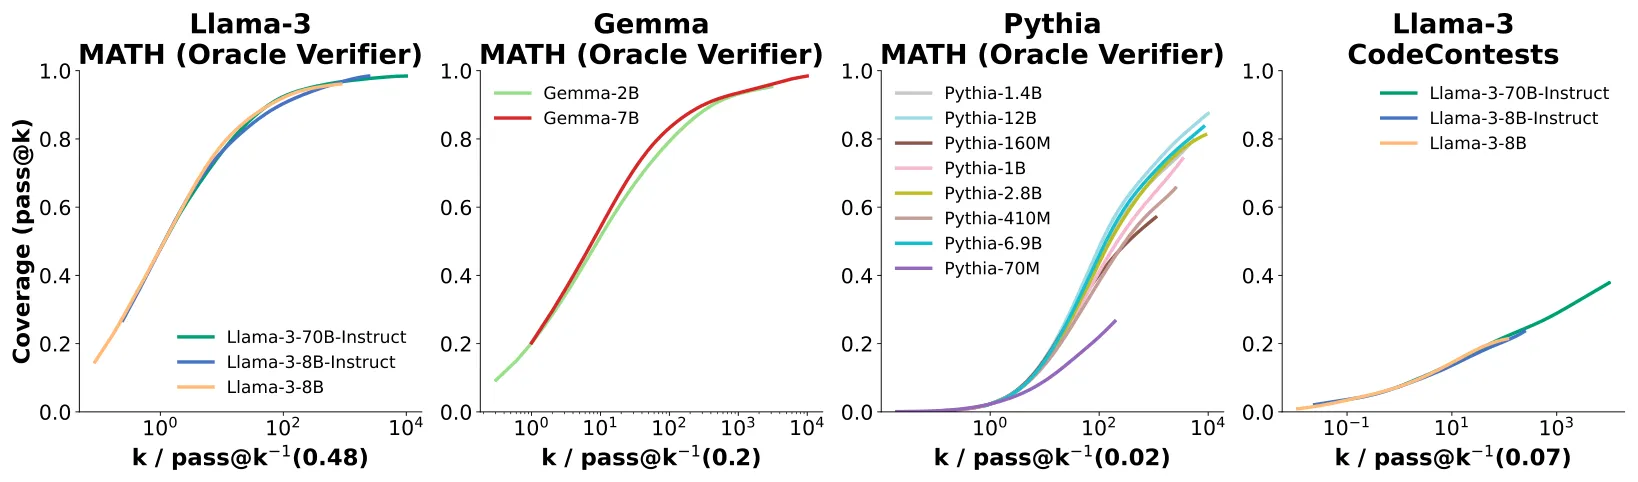
同一模型家族里,大模型往往不用尝试那么多次,就能达到小模型反复尝试后的覆盖率。比如,小模型要答 100 次,大模型也许答 20 次就能得到相近结果。把不同模型的横轴按各自所需的尝试次数重新缩放后,Llama、Gemma 和 Pythia 家族内部的曲线大致重合。
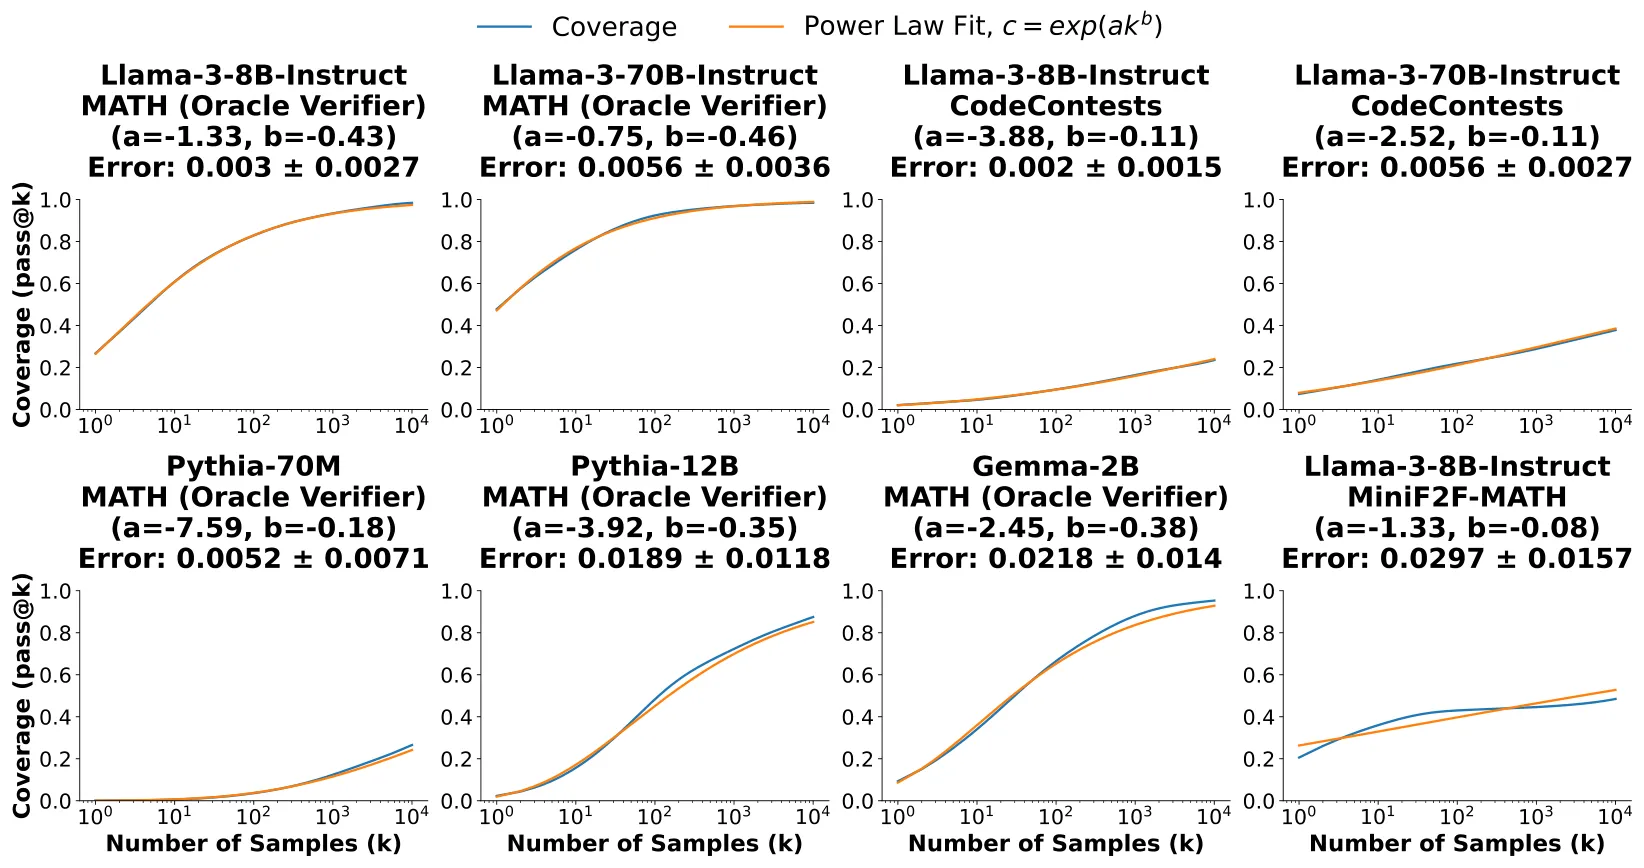
在论文测试的几个模型家族里,模型变大主要提高了“每次尝试有多管用”,没有完全改变重复采样的规律。CodeContests 和 MiniF2F 等偏离结果也提醒我们,这不是一条对所有任务都成立的定律。
论文还发现,随着尝试次数增加,数据集的平均候选覆盖率接近 100% 的速度常常可以用幂律近似。多数实验拟合得不错,MiniF2F 的偏差却比较大。这里留下了一个暂时解释不了的问题:单道题的失败率明明按指数下降,许多题平均以后为什么会像幂律?第三篇论文会回到这里。
第一篇论文画出的其实是一张“机会账单”:多尝试几次通常会看到更多正确答案,但它没有告诉我们,固定预算应该全部用来从头再答,还是留一部分去修改已经生成的答案。假如一道题总共允许生成 128 次,该怎样分配?这正是下一篇论文要解决的问题。
2. 修改答案和路径搜索何时有效?
Snell, Lee, Xu, Kumar, Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters,2024。arXiv:2408 .03314
假设一道题允许模型生成 128 次。可以从头生成 128 份互不相关的答案,也可以先生成几份,再反复修改其中较好的版本;如果还有模型能给中间步骤打分,还能把后续计算集中到更有希望的解题路径上。三种做法花掉的预算相近,搜索过程却完全不同。
Snell 等人做了两组实验。第一组比较“从头再答”和“沿着原答案继续改”;第二组把解题过程看成一棵搜索树,研究计算应该花在哪些分支上。这两组实验回答的是相关但不同的问题,不能把结果拼成一个统一算法。
修改答案和路径搜索不是同一组实验
第一组实验需要一个会改答案的模型。普通 PaLM 2 读完自己的旧答案后,并不擅长把它改对,作者为此专门训练了一个“修改模型”(revision model)。训练数据也不是真实的多轮改错记录:作者先让模型独立回答同一道题 64 次,再从这些答案中拼出“先错、后对”的修改序列。这个实验能说明模型是否会利用已有答案,不能说明它会在真实交互中自己学会试错。
第二组实验更像走迷宫。模型每写出几步,就可能产生几个后续方向。作者从每个中间步骤继续作答多次,看看最后有多少次能答对,再把这个比例当作“这条路有多大希望”。这种估分方式叫 Monte Carlo rollout,过程奖励模型(process reward model,PRM)则学习预测这个分数。
有了分数以后,搜索策略才知道怎样花剩余预算。Best-of-N 的办法最直接:生成多份完整答案,再挑分数最高的一份。Beam search 会边解题边淘汰低分路径,每一步只保留几条较有希望的思路。Lookahead search 则会临时往后多推几步,再决定当前留下哪条路。
这些结果来自专门训练的修改模型和 PRM,任务主要是 MATH 数学竞赛题。它不是给普通聊天模型换几条 prompt 就能复现的技巧。
题目难度因模型而异
两组实验都需要先判断题目难度。论文按每道题的 pass@1,也就是模型只答一次时的成功率,分成五档:模型经常答对的是容易题,几乎答不对的是困难题。这个难度不属于题目本身,而是模型与题目的关系。换一个更强的模型,同一道题可能就从困难档掉到中等档。
实验可以事后生成 2,048 份答案,再根据成功比例判断难度。论文把这种近乎“提前知道答案”的分法叫 oracle 难度。部署时显然不能这么做,否则光判断难度就把预算花完了。作者试过用 PRM 的平均分估计难度,结果比较接近,但打分本身仍有成本。论文说明了按难度选策略有用,没有解决怎样便宜、可靠地判断难度。
容易题适合修改答案
修改实验里的规律比较直观。容易题通常已经走在大致正确的方向上,沿着原答案修改比较划算。题目变难后,原思路本身就可能错了,此时应该保留更多从头生成的答案,免得所有预算困在同一条路上。按难度调整两者比例后,修改系统用 64 个样本超过了 Best-of-N 使用 256 个样本的结果,相当于约 4 倍的样本效率。
Beam search 保留高分路径,对中等题帮助最大
PRM 搜索得到的规律不太一样。Beam search 对中等难度题帮助最大。容易题本来就有不少正确路径,反复追逐 PRM 高分可能迎合评分器,结果反而变差;最难的题连有希望的开头都很少,搜索也无路可走。Lookahead search 在这组实验里同样没有带来预期收益。题目变难,并不意味着搜索一定更有用。
根据难度选择搜索策略后,在部分预算区间里,只花约四分之一的额外推理预算,就能接近“让 PRM 从所有完整答案中挑最高分”的结果。这里是接近,而不是超过;结论也只适用于论文使用的模型和 MATH 任务。
MATH 数学题最难档:换强模型优于修改或搜索
作者还比较了两种花钱方式:让小模型多算一会儿,或者直接换成参数量约大 14 倍的模型,并把两边使用的 FLOPs 控制在相近水平。容易和中等题仍在小模型能力范围内,多修改几次或用 PRM 搜索经常更划算;到了最难一档,这两种方法几乎不再带来提升,换更强的底座更有用。
这笔账还取决于模型将来会被调用多少次。部署问题数量有限时,省下的训练计算可以多花在推理上;调用量极大时,每道题反复搜索的成本会长期累积,优势可能缩小甚至反转。所以,这组实验真正支持的是:在 MATH 和当前系统里,只要题目仍处于模型的能力范围,按难度选择推理策略可能比统一增大模型更省计算。它限制的是论文测试的修改和 PRM 搜索方法,不能推广成“所有额外推理都救不了难题”,也没有证明推理可以替代训练。
Snell 讨论的是一道题里的预算安排。下一篇换一个尺度,回到第一篇论文留下的平均曲线:每道题的成功概率各不相同,把它们放在一起统计以后,候选覆盖率为什么会像幂律?
3. 多道题平均后,为何会出现幂律?
Schaeffer et al., How Do Large Language Monkeys Get Their Power (Laws)?,ICML 2025。arXiv:2502 .17578
第三篇论文没有提出新的搜索方法,它回头解释第一篇论文里那条奇怪的曲线。类似曲线也出现在 Best-of-N 越狱实验中:对同一条有害 prompt 尝试攻击 次,只要有一次绕过安全限制,就算攻击成功。Schaeffer 等人想知道的是,为什么把很多 prompt 或很多题目放在一起统计后,平均结果会像幂律。
单题偶尔能答对,失败率就会指数下降
先只看一道题。假设模型每次有 10% 的概率答对,那么一次失败的概率是 90%,连续两次都失败是 ,连续 次都失败就是 。把第 道题的单次成功率写成 ,公式就是:
只要 ,失败率就会随着采样次数指数下降。单道题内部没有幂律。
麻烦出在题目难度不同。有的题一次就经常答对,有的题可能一千次才偶尔对一次。对包含 道题的基准,论文先算每道题的 pass@k,再取平均:
当平均候选覆盖率越来越接近 1 时,直接看曲线不容易分辨差异。作者对它取负对数,发现在一段预算范围内近似下面的形式:
这里取对数只是换一个更容易观察差异的刻度,并没有改变原始实验结果。
低成功率题目拖慢了平均覆盖率
可以把题库想成一场长跑。容易题只采样几次就饱和,很快退出了比赛;预算继续增加后,平均误差主要来自成功率更低的题。等这一批题也接近饱和,又会有更难的题接手。拖住平均值的题一直在换,所以整条平均曲线比任何一道固定题都下降得慢。
论文把这种直觉写成了一个定理。把所有可能遇到的题看成一个任务分布 ,每道题都有自己的单次成功率 。这里的“密度”可以粗略理解为:成功率落在某个区间里的题有多少。假设不断有 接近零、但还不是零的题出现,并且成功率的密度 在零附近大致满足:
那么数据集平均后的曲线会满足:
其中 。不想追公式也没关系,需要记住的只有一句:成功率极低的题越多,平均候选覆盖率的尾巴就越长;幂律指数描述的正是这批题在零附近怎样分布。
这个结论有两个边界。第一种情况是模型无论采样多少次都做不出某些题,也就是这些题的 ;平均候选覆盖率最终会停在 1 以下。第二种情况是题库固定且有限,所有题的成功率又都大于零;采样次数足够大以后,只剩成功率最低的那道题还没饱和,曲线最终会重新变成指数形状。因此,论文里的幂律只描述某个任务分布,或当前预算范围内看到的统计规律。
难题比例影响平均曲线
题目分布一变,曲线自然也会变。越狱实验里,Llama-3-8B-Instruct 在给定预算内攻破了每一条 prompt,没有一批迟迟无法攻破的样本拖住平均值,曲线就比幂律下降得更快。
第一篇论文中的 MiniF2F 也拟合得不好。第三篇论文没有专门分析这组数据,只能谨慎猜测:这个模型和题库的组合,在当前采样范围内可能没有形成足够长的“超难题尾巴”。这不能说明增加推理预算在 MiniF2F 上无效。
少量样本可预测增加采样后的平均覆盖率
理解了曲线的来源,还能少做一些实验。常规方法需要真的尝试许多不同的 ,再用这些点拟合曲线。论文选择先用较少样本估计每道题的成功率分布,再从这个分布推算更大 时会发生什么。
最难估计的仍然是那些一次都没答对的题。假设此前每题只试了 次,它们可能真的完全不会,也可能只是成功率低于 ,暂时没有抽中。有限样本分不清这两种情况,作者用带有可调尾部的概率分布(三参数 Beta 或 Kumaraswamy)来估计这段看不见的区域。
在合成数据回测中,这种方法估出的幂律指数更接近真实值,误差约缩小到原来的十分之一。若要达到相近的误差,理论上可以少用约 100 到 10,000 倍的推理量。这个数字来自论文的模拟和回测,不能直接套到任意新数据集。
第三篇论文解释完了题库的平均曲线。最后一篇再换一个尺度:真实的 Agent 往往会调用多个模型,并在生成之后加入检查和整合步骤。步骤一多,就需要决定整条流程该怎样安排。Archon 不使用前面的幂律估计,也没有直接纳入 Snell 的 PRM 搜索。
4. 多个模型该怎样协作?
Saad-Falcon et al., Archon: An Architecture Search Framework for Inference-Time Techniques,2025。arXiv:2409 .15254
真实的 Agent 系统往往不只调用一次模型。它可以请几个模型分别作答,让另一个模型挑错,再让最后一个模型整合答案。Archon 要自动寻找的,就是这套工作流程。
它和 Snell 的搜索不是一回事。Snell 在解一道数学题时决定接下来扩展哪条思路;Archon 在系统运行前决定调用哪些模型、每个模型调用几次,以及它们按什么顺序协作。Snell 使用的 PRM 和难度路由没有直接放进 Archon。
Archon 的三类组件:生成、筛选与评价、融合
先看一条最简单的 Archon 流程。用户提出问题后,系统请几个模型各写一份答案;批评器找出每份答案的问题,排序器留下较好的几份;最后,融合器读完候选和批评意见,重新写出一份答案。原始问题和当前候选会一直传到下一层。
论文把这些步骤分成三组:
- 生成:生成器(generator)用一个或多个模型产生候选。
- 筛选与评价:排序器(ranker)给候选排序,批评器(critic)补充评价意见,LLM 评分器(verifier)判断答案质量,单元测试生成器和评估器则为代码候选提供检查信息。这些组件有的添加信息,有的排序或过滤候选,并不都直接删除答案。这里的 verifier 是模型组件,不等同于规则检查器或 Snell 的 PRM。
- 融合:融合器(fuser)读取多条候选和评语,写出一条新的答案。
融合器和普通选择器有一个重要区别。第一篇论文中的选择器只能从现有答案里挑一份;融合器可以吸收几份答案各自有用的部分,写出一份原来不存在的新答案。这样做可能比“挑出最好的一份”更强,也带来了新的风险:融合器同样可能在重写时引入错误。在开放式回答基准上,论文主要用另一个 LLM 充当裁判;数学和代码基准仍使用标准答案或测试,所以不同任务上的分数并不具有完全相同的可信度。
组件不能任意排列。生成器必须先给出候选,批评器要在排序或融合之前工作,流程通常由融合器收尾。因此,Archon 不是凭空发明任意调用图,而是在作者预先规定的合法流程中找配置。
不同任务需要不同的组件组合
实验没有找到一套到处都最好的流程。不同任务对融合层数的反应并不一样:MixEval 通常只提升 1 到 2 个百分点;在 MT-Bench 和 AlpacaEval 2.0 上,使用 3 到 4 层融合却能增加 10 到 15 个百分点。
代码任务又是另一种情况。CodeContests 中,反复融合和排序的帮助有限;让强模型多生成几份代码,再让模型写出文本形式的测试条件,并据此评价候选,更有效。这里并不是把代码放进真实仓库里运行确定性测试。任务不同,值得多花预算的环节也不同。
寻找合适流程也有计算成本
Archon 要决定的事情很多:用几个生成模型,每个模型生成几份答案,安排几轮融合,要不要加入批评器、排序器和最后的评分器。去掉输入太长、超过模型一次能够读取的内容上限等无法运行的结构后,仍然有 9,576 种配置;CodeContests 甚至允许单个模型生成 1,000 份代码。
把 9,576 种配置全部跑一遍太贵了。作者先拿目标数据集的 20% 作为开发集,在这部分数据上寻找流程,再到剩余 80% 上评测。搜索时既可以只追求准确率,也可以同时限制模型调用成本。
论文比较了三种找法。随机搜索随便试配置,贪心搜索每次沿当前最好的方向改一点,贝叶斯优化则根据已经测过的结果,预测下一批最值得尝试的配置。贝叶斯优化通常先随机测试 230 到 240 个配置,再开始预测。
在作者的实验里,贝叶斯优化有 96.0% 的时候找到了三种方法中最好的配置。为了找到各自的最佳结果,它比贪心少测试 88.5% 的配置,比随机搜索少测试 90.4%。省下的是“寻找工作流程”的实验次数,不是系统回答每个问题时的计算量。
调用预算低于 20 次时,可选结构本来就少,贝叶斯优化和另外两种搜索方法相差不大。如果任务价值不高、分布经常变化,或者没有代表性开发集,流程搜索的前期成本也很难摊薄。
实验条件不同,性能提升不能直接比较
| 设置 | 论文报告的比较结果 |
|---|---|
| 只用开源模型 | 相对当时的开源单模型方法,平均提高 11.2% |
| 使用闭源模型的任务定制架构 | 在四个基准上,相对闭源单模型平均提高 15.1% |
| 与其他多模型推理框架(MoA、ADAS、AFlow)比较 | 平均提高 8.4%,同时少用 20.0% 的调用、15.1% 的输入 token 和 13.5% 的输出 token |
表里的数字不能合并成一句“Archon 固定提升 15.1%”,因为任务、候选模型、负责打分的模型、开发集和比较基线都不同。论文找到的最佳架构往往需要约 30 到 40 次模型调用,多层顺序调用可能达到单模型请求约 5 倍的延迟和费用。这里说的“更高效”,是相对其他重型推理框架而言,不是相对一次普通调用。
总结:何时值得增加推理预算?
真正落地时,我会先把候选覆盖率和最终准确率分开看。前者上升、后者不动,说明瓶颈多半在检查或筛选。两者都不动,只能先判断继续增加同一种预算已经没有明显收益;原因可能是底座能力不足,也可能是当前生成方法没有探索到有效路径。
接着再把调用次数、token、延迟和检查开销放在一起算。只有任务会反复出现时,Archon 这类流程搜索的前期成本才有机会摊薄。这样才能回答两个实际问题:系统为什么变好了,以及这点提升值不值得花钱。
这也回答了 Lecture 2 最初的问题:额外计算买到的是更多生成、修改、检查和重组答案的机会。它不会让模型当场学会新能力,只是让 Agent 更好地调用已有能力;如果这些步骤不能产生或利用有用信息,多算只会制造更多错误。